兩條 SQL 同一個答案,一條是錯的:問數進入可核查時代
KNOWIDEA 聯同佐治亞理工與貝萊德發布 VeriPIE 論文:兩條 AI 生成的 SQL 今日返回同一個數,聽日就可能靜靜分歧。多數投票救不了,答案必須自帶可核查的證據鏈。
先講結論:Text-to-SQL 最危險的錯誤不是報錯,而是跑得通、返回一個看似合理的數字、但計算邏輯是錯的。 2026 年 10 月 13 日,決策智能公司 KNOWIDEA 聯同佐治亞理工(Georgia Tech)與貝萊德(BlackRock)的研究人員發布 VeriPIE 論文,把這個問題擺上枱面:兩條針對同一個數據庫、同一條問題的 AI 生成查詢,今日返回完全相同的答案,換一日數據就可能一個靜靜剔除賬戶、一個如實返回——中間冇任何報錯和警告。
呢篇論文指出的方向好明確:問數系統的競爭焦點,正在由「答得準」轉向「可核查」——每個答案都要附帶一套風險團隊喺據此決策之前能夠獨立驗證的證據。
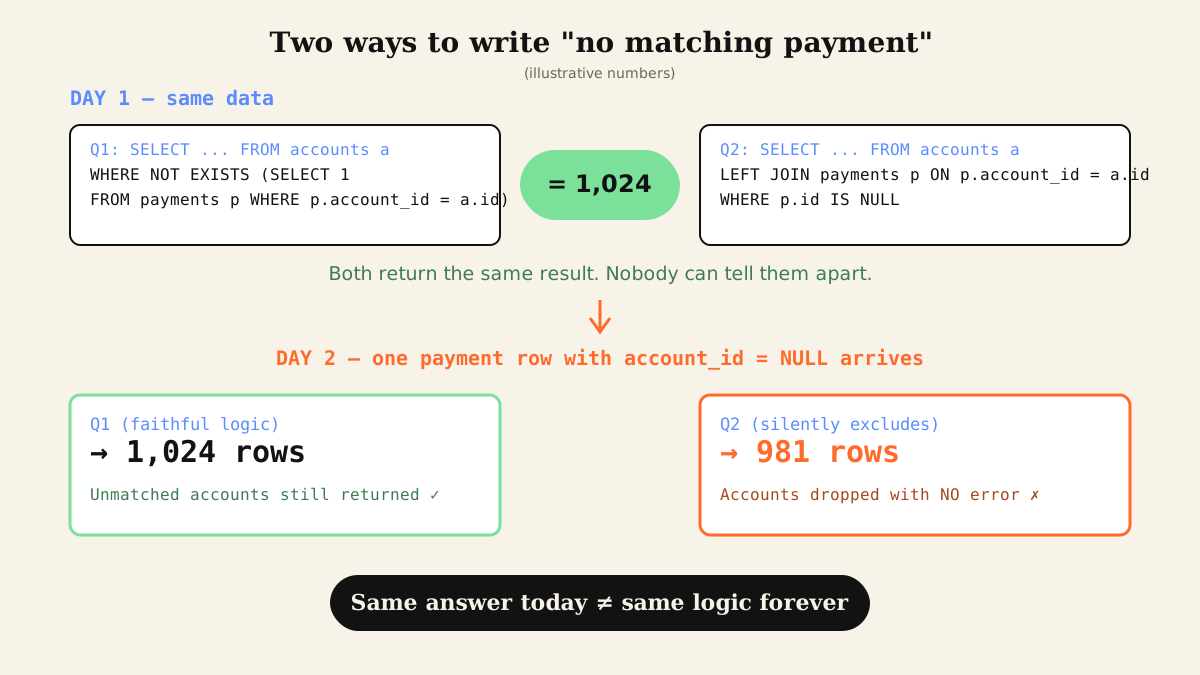
1. 嗰個經典陷阱:「冇匹配付款」的兩種寫法
論文入面最紮心的例子,來自一條再普通不過的業務問題:找出「冇匹配付款」的記錄。
寫呢個條件有兩種常見方式,喺現有數據上,兩條 SQL 返回一模一樣的結果。然後,數據入面出現一條 account_id 缺失的付款記錄——其中一種寫法會靜默剔除所有未匹配賬戶,另一種則如實返回。報表看似依然完整,實際上已經缺了一角。
KNOWIDEA 喺新聞稿直接點名呢類錯誤的後果:一條錯誤的查詢「可以在返回貌似合理結果的同時,靜靜漏掉風險敞口、重複計算交易、或者計錯財務匯總」:
- 風控:漏掉的敞口會低估投資組合的真實風險;
- 監管申報:重複計算會令申報數字失實;
- 對賬:本該找出斷位的對賬查詢,自己先丟失了斷位。
呢個不是杞人憂天。我哋喺 8 月尾的真實企業庫 Text-to-SQL 實測已經見過同類案例:一條漏掉去重步驟的查詢將收入放大了 76%,輸出結果看似完全合理,直到熟悉業務的人覆核先至發現。
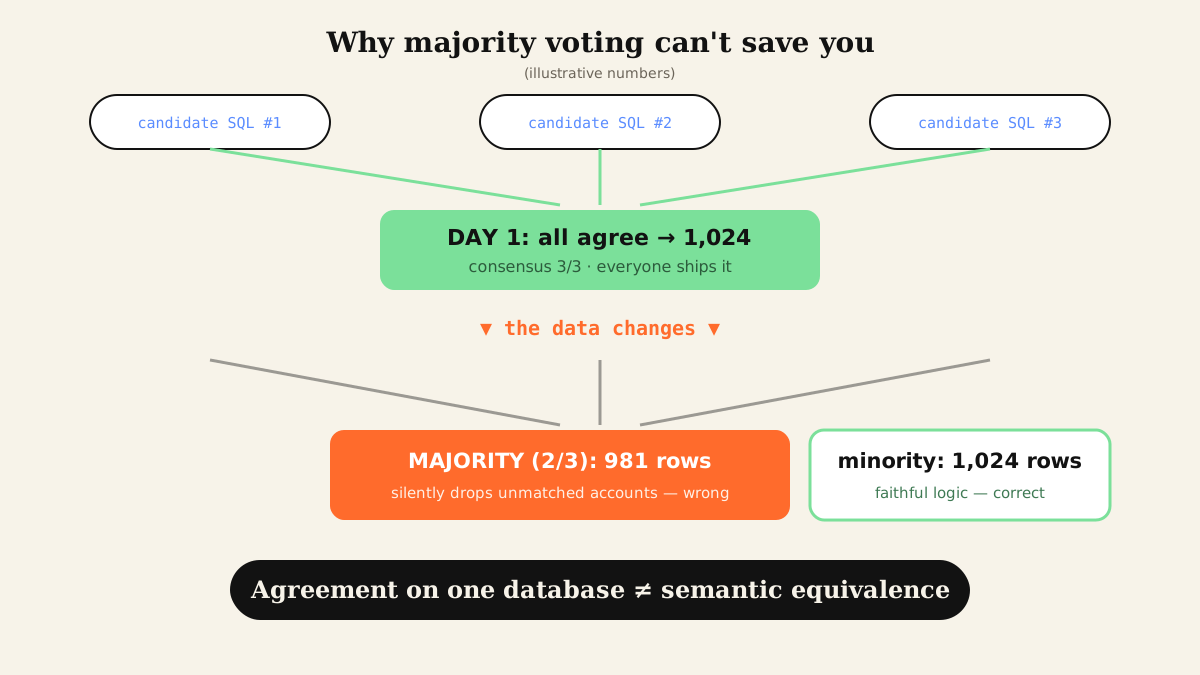
2. 點解「多數投票」救不了
面對呢個問題,目前主流的工程做法是多候選投票(self-consistency):畀模型生成多條 SQL,取「大多數查詢都同意」的結果。
VeriPIE 論文指出呢個做法並不充分,理由只得一句,但分量好重:「喺同一組數據上一致,並不能證明語義等價」——兩條查詢可以在今日的數據上返回相同結果,聽日數據一變就各走各路。投票選出來的其實是「今日大家湊巧一致」,而不是「計算邏輯正確」。
論文仲舉了一個更隱蔽的例子:將問題入面明確畀出的 SUM(x)/COUNT(*) 公式替換成 AVG(x)——前者分母統計所有行,後者自動排除空值。兩個寫法喺「冇空值」的數據上答案完全相同,一旦某個欄位出現 NULL,結果就靜默分叉。
3. VeriPIE 的解法:畀每條候選查詢帶住證據嚟面試
VeriPIE 的核心思路是神經符號(neurosymbolic):用大模型生成,用定理證明器校驗。成條流水線係咁:
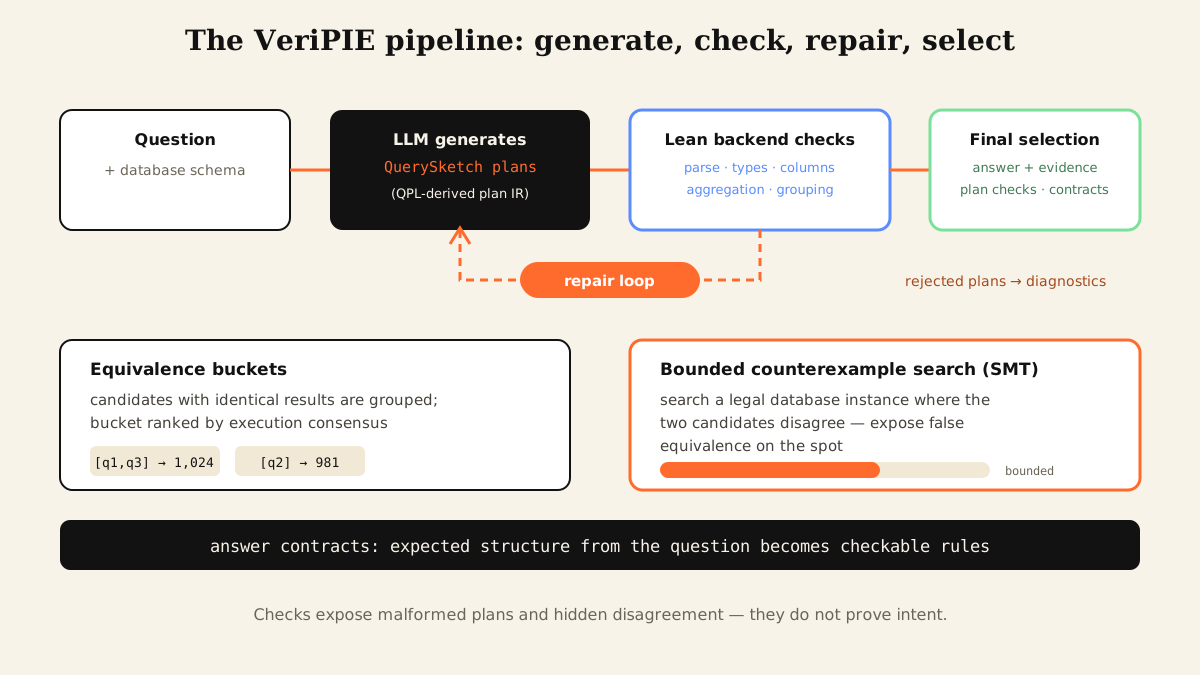
- 生成結構化查詢計劃:模型不直接寫 SQL,而是先輸出一種叫 QuerySketch 的中間計劃語言(脫胎於查詢計劃語言 QPL),將「掃邊張表、點過濾、點關聯、點聚合」逐步寫清楚;
- Lean 定理證明器校驗:計劃經過解析、類型檢查(表、欄位、類型、聚合、分組、輸出形狀),唔合格的計劃返回結構化診斷資訊,驅動模型修復;
- 答案契約(answer contracts):將問題入面隱含的預期結構變成可校驗的規則,例如「輸出必須包含呢兩欄」;
- 等價分桶 + 有界反例搜索:執行結果相同的候選歸入一組,再用 SMT 求解器喺有限範圍內搜索「反例數據庫」——如果兩條查詢喺某個合法數據實例上結果不同,就當場拆穿「假等價」;
- 選擇:綜合執行共識、計劃校驗和反例搜索的證據做最終排序。
一個好說明呢種設計哲學的細節:系統內置手工安全規則,專門攔截 AVG(x) 替換 SUM(x)/COUNT(*) 呢類「語法合法、語義偷換」的操作。
效果如何?論文喺完整的 Spider 開發集同 BIRD 上做了單次運行實驗:
| 指標 | VeriPIE | 對比基準 |
|---|---|---|
| Spider 開發集測試套件準確率 | 72.05%(745/1,034) | DeepEye 65.67%(679/1,034) |
| Spider 兩查詢候選覆蓋率 | 78.43%(811 題) | DIN-SQL 74.66%、DeepEye 69.05% |
| BIRD 執行準確率 | 68.90% | — |
| BIRD 兩查詢候選覆蓋率 | 73.73% | — |
單看準確率,提升是漸進的。但論文自己都講得好克制:呢啲校驗並不能證明查詢符合用戶意圖,佢哋的價值在於「暴露畸形計劃和隱藏的分歧」——即是將「呢個答案憑乜可信」由一句口頭承諾,變成一疊可以翻閱的證據。
4. 對企業落地意味著乜嘢
呢篇論文出現的時機不是偶然。文章開篇就把背景釘在金融行業:模型風險管理(MRM)框架強調獨立驗證、透明度和有效挑戰,金融穩定理事會(FSB)將 AI 相關的模型風險、數據質素和治理列為金融穩定脆弱性,歐盟 AI 法案亦引入了基於風險的合規要求。換句話說,喺金融場景,「可核查」不是加分項,是准入條件。
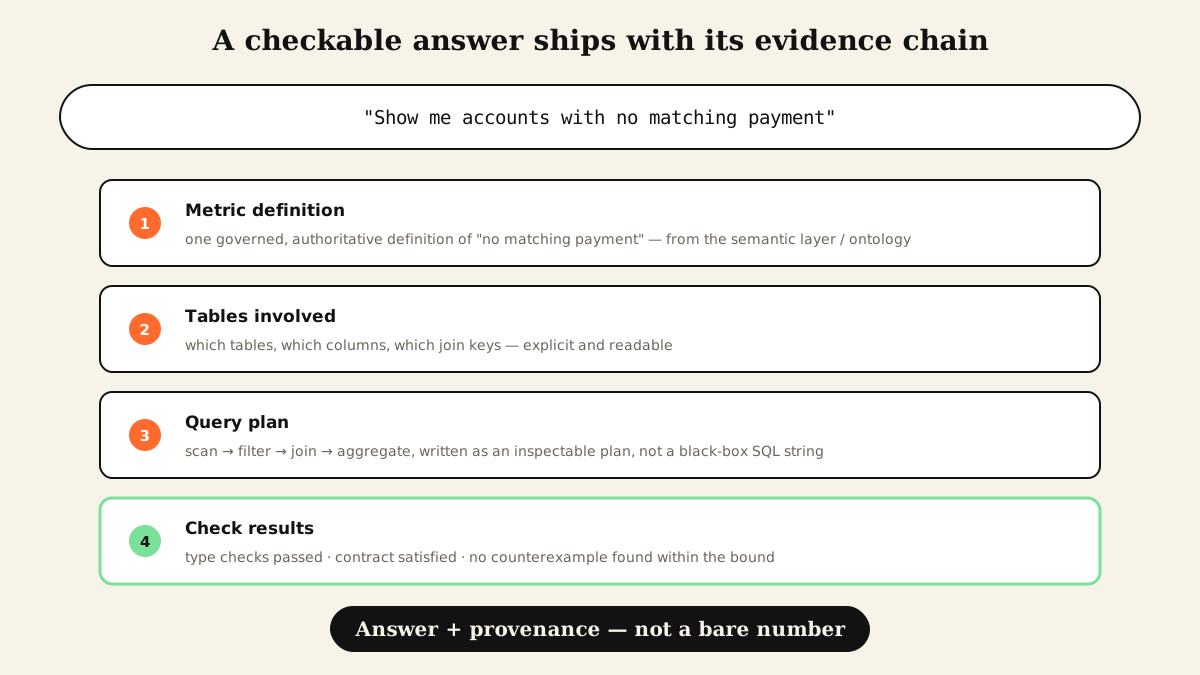
對正在落地問數能力的企業,我哋建議將三件事提上日程:
第一,每個答案帶證據鏈。 問題→口徑定義→涉及嘅表→查詢計劃→校驗結果,呢條鏈要完整、可追溯、人讀得明。用戶見到的應該是「答案 + 憑據」,而不是一個孤零零的數字。
第二,口徑定義要入語義層。 「冇匹配付款」呢類業務定義必須有一個唯一、受治理的權威出處,而不是散落喺每個分析師的 SQL 入面。呢個正是同一日本地討論的由數據到 Context 的實踐強調的方向:業務定義要成為查詢過程的輸入。OntiCards 的做法是將指標口徑、關聯關係沉澱為本體資產,智能體查詢前先對齊定義,再落成查詢。
第三,校驗對賬常規化。 與其等審計先發現問題,不如將「答案啱唔啱」變成日常流程:數據校驗對賬能力應該內置喺問數鏈路入面,每日自動比對、自動暴露分歧。呢個亦是我哋喺智能體治理入面反覆強調的思路——可託付比聰明更值錢。
模型仲會繼續變強,基準分數仲會繼續上升。但只要企業仲指望攞呢啲數字去報監管、控風險、做決策,「看似啱」就永遠唔夠,畀人核查先至是問數的合格線。