两条 SQL 同一个答案,一条是错的:问数进入可核查时代
KNOWIDEA 联同佐治亚理工与贝莱德发布 VeriPIE 论文:两条 AI 生成的 SQL 今天返回同一个数,明天就可能悄悄分歧。多数投票救不了,答案必须自带可核查的证据链。
先说结论:Text-to-SQL 最危险的错误不是报错,而是跑通、返回一个看起来合理的数字、但计算逻辑是错的。 2026 年 10 月 13 日,决策智能公司 KNOWIDEA 联同佐治亚理工(Georgia Tech)与贝莱德(BlackRock)的研究人员发布了 VeriPIE 论文,把这个问题摆上了台面:两条针对同一个数据库、同一个问题的 AI 生成查询,今天返回完全相同的答案,换一天数据就可能一个悄悄剔除账户、一个如实返回——中间没有任何报错和警告。
这篇论文给出的方向很明确:问数系统的竞争焦点,正在从「答得准」转向「可核查」——每个答案都要附带一套风险团队在据以决策之前能独立验证的证据。
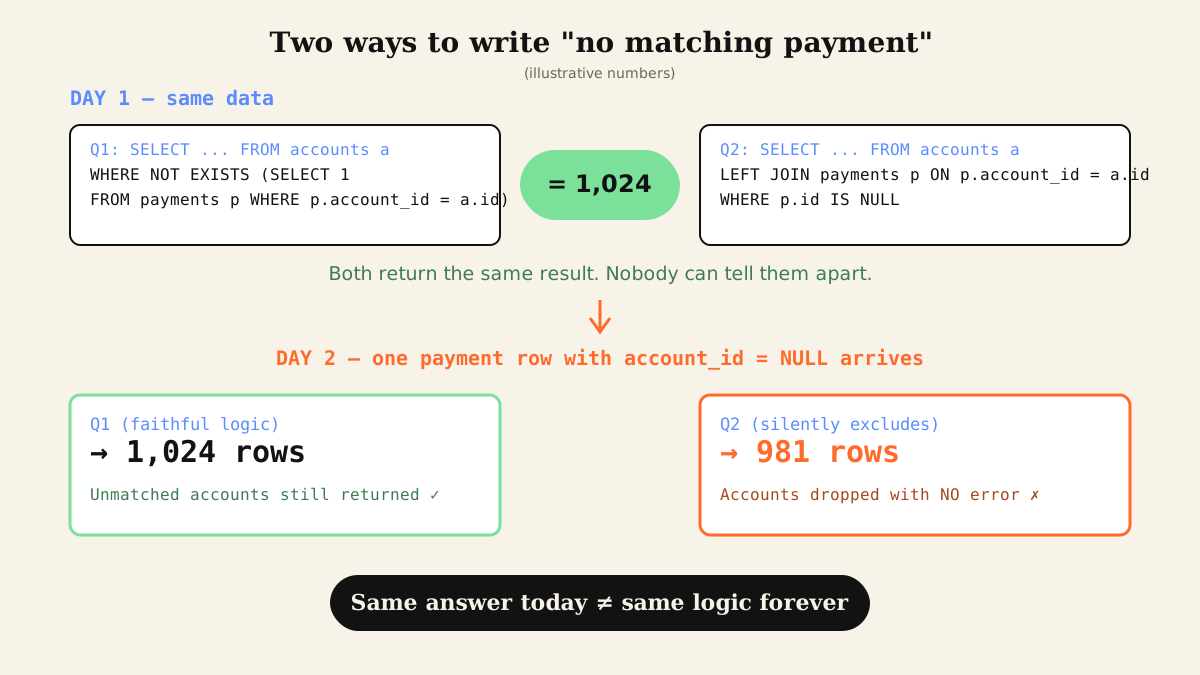
1. 那个经典陷阱:「没有匹配付款」的两种写法
论文里最扎心的例子来自一个再普通不过的业务问题:找出「没有匹配付款」的记录。
写这个条件有两种常见方式,在当前数据上,两条 SQL 返回一模一样的结果。然后,数据里出现了一条 account_id 缺失的付款记录——其中一种写法会静默剔除所有未匹配账户,另一种则如实返回它们。报表看起来依然完整,实际上已经缺了一块。
KNOWIDEA 在新闻稿里直接点名了这类错误的后果:一条错误的查询「可以在返回貌似合理结果的同时,悄悄漏掉风险敞口、重复计算交易、或算错财务汇总」:
- 风控:漏掉的敞口会低估投资组合的真实风险;
- 监管报送:重复计算会让申报数字失实;
- 对账:本该找出断点的对账查询,自己先丢掉了断点。
这不是杞人忧天。我们在 8 月底的真实企业库 Text-to-SQL 实测里就见过同类案例:一个漏掉去重步骤的查询把收入放大了 76%,输出结果看起来完全合理,直到懂业务的人复核才发现。
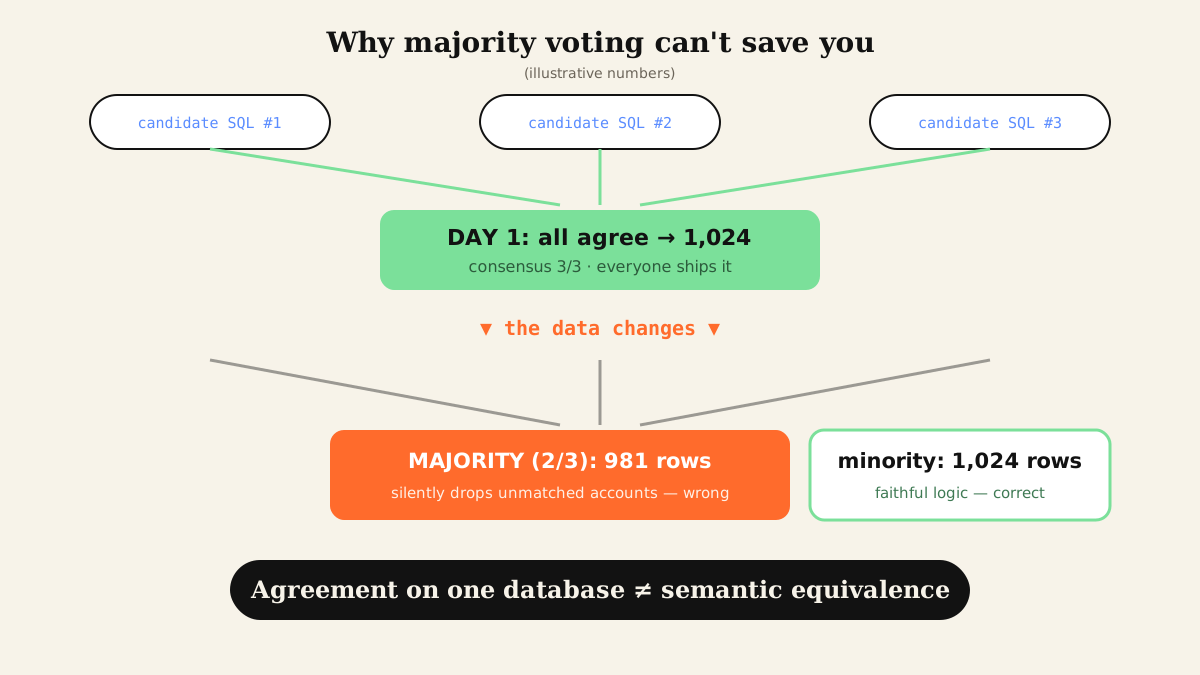
2. 为什么「多数投票」救不了
面对这个问题,目前主流的工程做法是多候选投票(self-consistency):让模型生成多条 SQL,取「大多数查询都同意」的那个结果。
VeriPIE 论文指出这并不充分,理由只有一句话,但分量很重:「在同一条数据上一致,并不能证明语义等价」——两条查询可以在今天的数据上返回相同结果,明天数据一变就分道扬镳。投票选出的其实是「今天大家碰巧一致」,而不是「计算逻辑正确」。
论文还举了一个更隐蔽的例子:把问题里明确给出的 SUM(x)/COUNT(*) 公式替换成 AVG(x)——前者分母统计所有行,后者自动排除空值。两个写法在「没有空值」的数据上答案完全相同,一旦某个字段出现 NULL,结果就静默分叉。
3. VeriPIE 的解法:让每个候选查询带着证据来面试
VeriPIE 的核心思路是神经符号(neurosymbolic):用大模型生成,用定理证明器校验。整条流水线是:
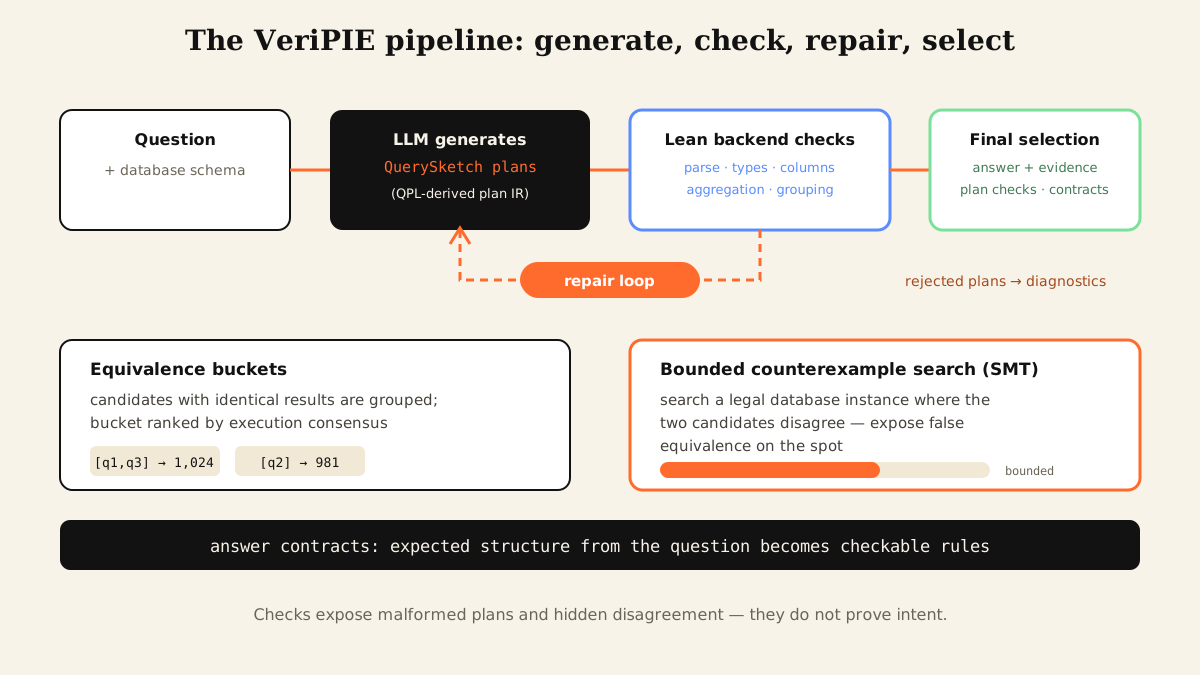
- 生成结构化查询计划:模型不直接写 SQL,而是先输出一种叫 QuerySketch 的中间计划语言(脱胎于查询计划语言 QPL),把「扫哪张表、怎么过滤、怎么关联、怎么聚合」逐步写清楚;
- Lean 定理证明器校验:计划经过解析、类型检查(表、列、类型、聚合、分组、输出形状),不合格的计划返回结构化诊断信息,驱动模型修复;
- 答案契约(answer contracts):把问题里隐含的预期结构变成可校验的规则,比如「输出必须包含这两列」;
- 等价分桶 + 有界反例搜索:执行结果相同的候选归入一组,再用 SMT 求解器在有限范围内搜索「反例数据库」——如果两条查询在某个合法数据实例上结果不同,就当场拆穿「假等价」;
- 选择:综合执行共识、计划校验和反例搜索的证据做最终排序。
一个能说明这种设计哲学的小细节:系统内置了手工安全规则,专门拦截 AVG(x) 替换 SUM(x)/COUNT(*) 这类「语法合法、语义偷换」的操作。
效果如何?论文在完整的 Spider 开发集和 BIRD 上做了单次运行实验:
| 指标 | VeriPIE | 对比基线 |
|---|---|---|
| Spider 开发集测试套件准确率 | 72.05%(745/1,034) | DeepEye 65.67%(679/1,034) |
| Spider 两查询候选覆盖率 | 78.43%(811 题) | DIN-SQL 74.66%、DeepEye 69.05% |
| BIRD 执行准确率 | 68.90% | — |
| BIRD 两查询候选覆盖率 | 73.73% | — |
单看准确率,提升是渐进的。但论文自己也说得很克制:这些校验并不能证明查询符合用户意图,它们的价值在于「暴露畸形计划和隐藏的分歧」——也就是把「这个答案凭什么可信」从一句口头承诺,变成一摞可以翻阅的证据。
4. 对企业落地意味着什么
这篇论文出现的时机不是偶然。文章开篇就把背景钉在了金融行业:模型风险管理(MRM)框架强调独立验证、透明度和有效挑战,金融稳定理事会(FSB)把 AI 相关的模型风险、数据质量和治理列为金融稳定脆弱性,欧盟 AI 法案也引入了基于风险的合规要求。换句话说,在金融场景里,「可核查」不是加分项,是准入条件。
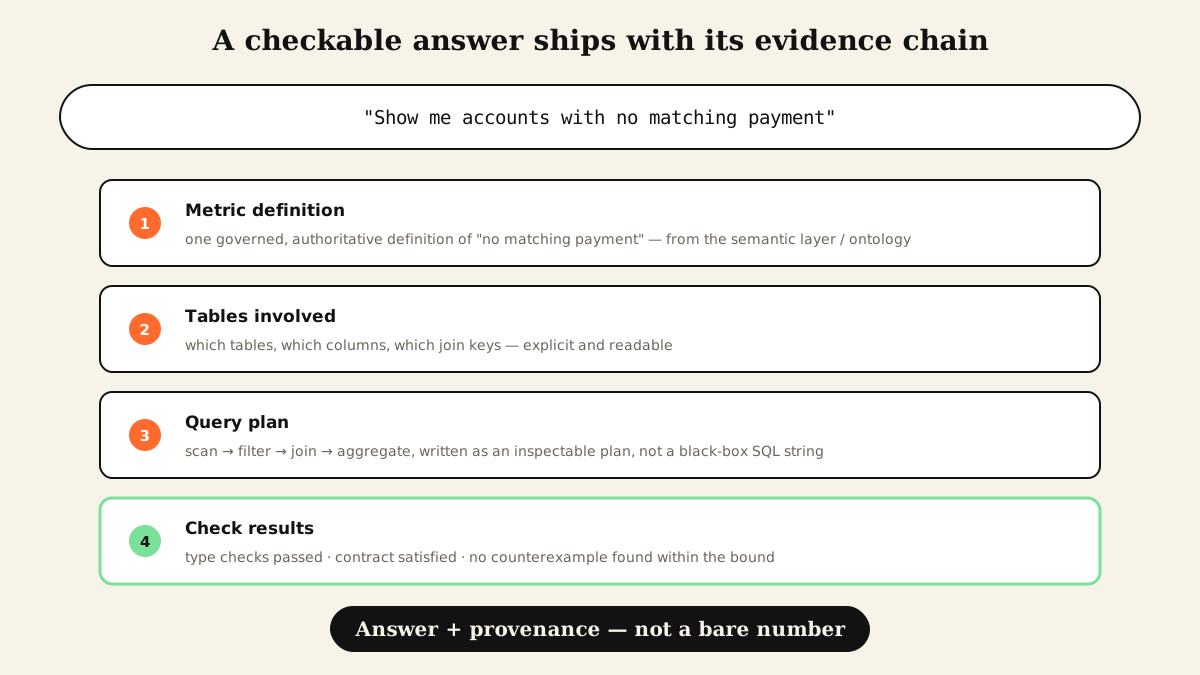
对正在落地问数能力的企业,我们建议把三件事提上日程:
第一,每个答案带证据链。 问题→口径定义→涉及的表→查询计划→校验结果,这条链要完整、可回溯、人能读懂。用户看到的应该是「答案 + 凭据」,而不是一个孤零零的数字。
第二,口径定义要进语义层。 「没有匹配付款」这类业务定义必须有一个唯一、受治理的权威出处,而不是散落在每个分析师的 SQL 里。这正是同一天国内讨论的从数据到 Context 的实践强调的方向:业务定义要成为查询过程的输入。OntiCards 的做法是把指标口径、关联关系沉淀为本体资产,智能体查询前先对齐定义,再落成查询。
第三,校验对账常态化。 与其等审计发现问题,不如把「答案对不对」变成日常流程:数据校验对账能力应该内置在问数链路里,每天自动比对、自动暴露分歧。这也是我们在智能体治理里反复强调的思路——可托付比聪明更值钱。
模型还会继续变强,基准分数还会继续上涨。但只要企业还指望拿这些数字去报监管、控风险、做决策,「看起来对」就永远不够,能被核查才是问数的及格线。