决策模型井喷:智能体说的 0.8,到底有多可信?
一个月内十家厂商跟进决策模型,智能体架构多出一层专用决策层。但独立评测显示几乎所有模型都过度自信,不同模型给出的 0.8 含义并不相同。定标这活儿,最终落在企业自己的数据与语义层上。
智能体架构在 10 月多出了一层专用「决策层」,但独立评测显示:几乎所有决策模型都过度自信,一家厂商的 0.8 和另一家的 0.8 不是同一回事。真正贵的不是这几毫秒的推理,而是把置信度阈值定准这件事——它依赖的标注数据、业务口径和历史案例,全都在企业自己手里。
一个月,从 1 家到 10 家
先给没跟过的读者一个定义:决策模型(decision model)是一种不做文本生成、只从固定答案集合里选一个并返回概率的 AI 模型。应用把状态(state)和一组带固定选项的问题发给它,它对每个选项返回一个概率,不做任何自由写作。
它解决的是智能体运行时的一类高频小决定:这张工单该路由给谁、下一步调用哪个工具、这个输出过没过护栏、要不要转人工。这类决定过去由大模型逐 token 生成回答,又慢又贵;决策模型把生成环节整个砍掉——AWS Strands 团队直接移除了模型的词元输出头,Liquid AI 的 d1 系列「不生成 token,一次前向传播就出答案」。
9 月 15 日 TypeSafe 发布 Jev 开创这个品类之后,一个月内跟进的厂商排到了十家(据 Tech AI Wire 10 月 15 日统计与至顶网 10 月 17 日报道):
| 日期 | 发布 | 形态 |
|---|---|---|
| 9 月 15 日 | TypeSafe Jev(品类开创者) | 托管 API |
| 9 月 29 日 | OpenAI Decisions API(GPT-6 Luna 驱动) | 公测,DevDay 发布 |
| 10 月 1 日 | Cloudflare Clef / Clef-flash | 开源权重,Apache 2.0 |
| 10 月 1 日 | AWS Strands Decider 2B | 开源,1.9B 参数 |
| 10 月 1 日 | Perplexity pplx-decider | 开源,Apache 2.0 |
| 10 月 7 日 | Liquid AI d1-3B / d1-omni-600M | 开源 |
| 10 月 9 日 | Cloudflare Clef-omni;Microsoft-Decision-1 上架 Foundry | 开源 / 托管 |
题型高度收敛为三种:是非判断(返回「是」的概率)、单选(每个选项一个概率)、打分(按概率加权落在有序刻度上)。托管的输入价格从每百万 token 0.02 美元到 0.24 美元不等,相差 12 倍;InfoWorld 按 Microsoft 的口径算过,1 美元能覆盖超过 27.5 万次同类短决定。
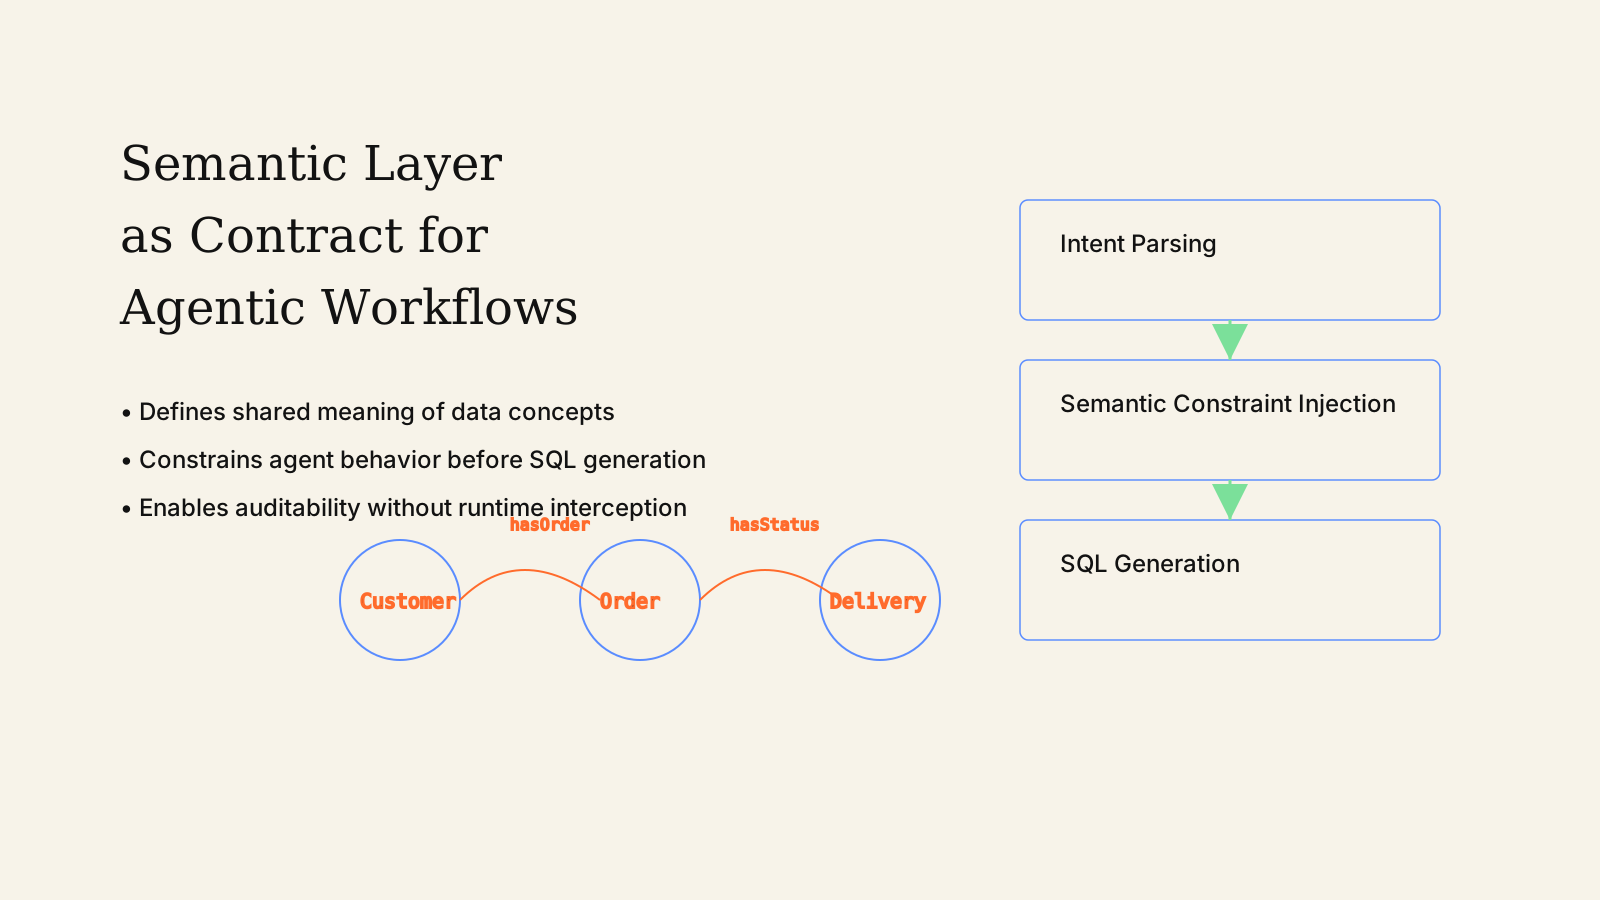
在智能体栈里,它的位置大概是这样的:
榜单泼的冷水:几乎人人过度自信
速度和价格是厂商自己测的,那独立评测呢?评测机构 Artificial Analysis 把 13 个决策模型放在同一张榜单上(SystemOne Models 10 月 16 日收录),结论不太客气:在几乎每一个概率区间上,每个决策模型的实际正确率都低于它自己声称的概率。
更扎眼的是置信度校准误差(ECE)随任务类型剧烈波动:Jev 在工具调用类任务上校准误差只有 0.05,在知识推理类测试 Humanity's Last Exam 上却高达 0.40——同一个模型,同一个「我 80% 确定」,在两种任务上完全不是一回事。
Laya 的案例最能说明问题:它的团队自己在测试中发现,模型对高棉文文本的正确率是 0%,却报出 95.2% 的平均置信度。一个「看起来很精确」的概率,会给不确定的决定镀上一层不该有的权威感——Kanerika 的 AI 开发经理 Amit Kumar Jena 对 InfoWorld 的这句提醒,值得贴在每个置信度消费方的监控面板上。
需要说明:上面是按公开评测数据整理的示意曲线,具体读数请以 Artificial Analysis 原始分箱图为准。另外榜单头部 d1-ultra(65.2 分)与 Jev 1.13(57.5 分)在「谁第一」上与另一张 Jev Decision Index 榜单结论相反——决策模型领域的基准之争,本身也还在打。
0.8 的含义,换一家就变
HFS Research 执行研究主管阿希什·查图尔维迪在接受至顶网采访时的警告,是这波井喷里最值得截图保存的一段话:「每个模型的置信度分数都有其自身的含义。Clef、Decider 和 Luna 给出的 0.8 概率值并不代表相同的可靠程度,因此针对某一模型调优的阈值无法直接套用到另一模型上。」
他指出的蔓延位置也很精准:不在推理层,而在「评估和校准环节」。企业切换供应商、或者同时跑多家方案时,必须按自己的数据重新校准每一个阈值。
超市巨头 H-E-B 的高级数据工程师阿迪蒂亚·兰詹补上了另一半账:错误决策的成本。一个错误决策可能引发下游连锁行动,最后的纠正成本可能超过推理本身省下的钱。他的建议是别只看推理支出,要按端到端工作流延迟、单次成功决策成本、决策准确率、运营开销、故障恢复成本五个维度来评估架构。
查图尔维迪还有一句更面向治理的话:每一个问题、答案集合和阈值都承载着一部分业务策略——什么时候批准退款、什么算重大事故。团队攒出几百个这样的「决策方案」后,它们会形成一套新逻辑体系,需要像提示词一样做版本管理、责任归属和审查。
校准这活儿,最后落在谁的头上
到这里逻辑闭环了:厂商不替你定标。OpenAI 的 Decisions API 文档没有公布任何校准数字,明确让开发者用自己的标注数据定阈值;AWS 的 Strands Decider 2B 发布说明也直接写明「在你自己的工作负载上重新验证」。TypeSafe 的 Jev 是托管服务,你连模型内部都看不到。
于是一个务实的校准闭环长这样(综合 OpenAI 开发者指南与多家厂商建议):
- 每类问题收集几百个历史案例,由领域专家标注正确答案;
- 扫描阈值,画出「错放」与「转人工比例」的权衡曲线;
- 在边际人工成本不再换来明显准确率提升的位置定 cutoff;
- 留一份从未参与调参的验收集,上线前复测;
- 新方案先以影子模式跑真实流量、不实际执行,达标后再切换,并保留旧路由随时回退。
注意这套流程里用到的所有原料:历史案例、专家标注、业务口径、「什么算重大事故」的定义。没有一样在模型厂商手里。这正是我们在可核查问数和语义层衰减里反复遇到的那堵墙:智能体进了企业核心流程,撞上的从来不是模型能力,而是组织知识——定义、口径、标注、责任。
决策模型把这堵墙又往前推了一寸:现在连「0.8 意味着什么」都成了企业要自己回答的问题。
写在最后
决策模型本身是好事——把智能体里高频、可枚举的小决定剥离出来,省钱省时延,方向没有问题。问题在于它把最后一公里交还给了企业:阈值要在你的数据上调,口径要在你的组织里定,几百个决策方案要有人管。
如果你的团队正在往工作流里接入这类组件,先把三件事备齐:按问题类型分好的历史标注案例、一份写清楚业务口径的定义表、以及让这些资产可持续维护的语义层。这也是 OntiCards 在做的事——用本体和卡片把企业的定义、口径、数据质量收拢成一层的产品能力,让上层无论换哪家模型,校准的地基不用推倒重来。
有类似困境欢迎来信 hello@onticards.com 聊聊你的场景。
参考来源
- 至顶网:《AI智能体决策层独立化,科技巨头竞相布局专用模型》(2026-10-17)—— https://www.zhiding.cn/ai-infrastructure/2026/1017/3202554.shtml
- Tech AI Wire: "AI decision models, explained"(2026-10-15)—— https://dev.to/techaiwire/ai-decision-models-explained-59mh
- Artificial Analysis 榜单转载(SystemOne Models): "Jev benchmarks: every public evaluation in one place"(2026-10-16 读数)—— https://systemonemodels.org/guides/jev-benchmarks
- Agor: "Whose Eighty Percent" —— https://agor.me/blog/whose-eighty-percent
- AiCybr: "AWS Strands Decider 2B: Open Decision Model for Local AI Agents" —— https://aicybr.com/blog/aws-strands-decider-2b-local-agent-decision-model
- World Programming: "OpenAI Decisions API: A Practical Developer's Guide" —— https://www.worldprogramming.org/posts/openai-decisions-api-a-practical-developers-guide-6wfccn