语义层不是AI的补丁,而是Agent的契约
本文揭示语义层的本质转型:从服务人类报表的口径对齐工具,升维为约束AI Agent行为的机器可执行契约。它显式建模数据意图、权限边界与执行上下文,在运行时保障合法、可审计、可演进的智能执行。
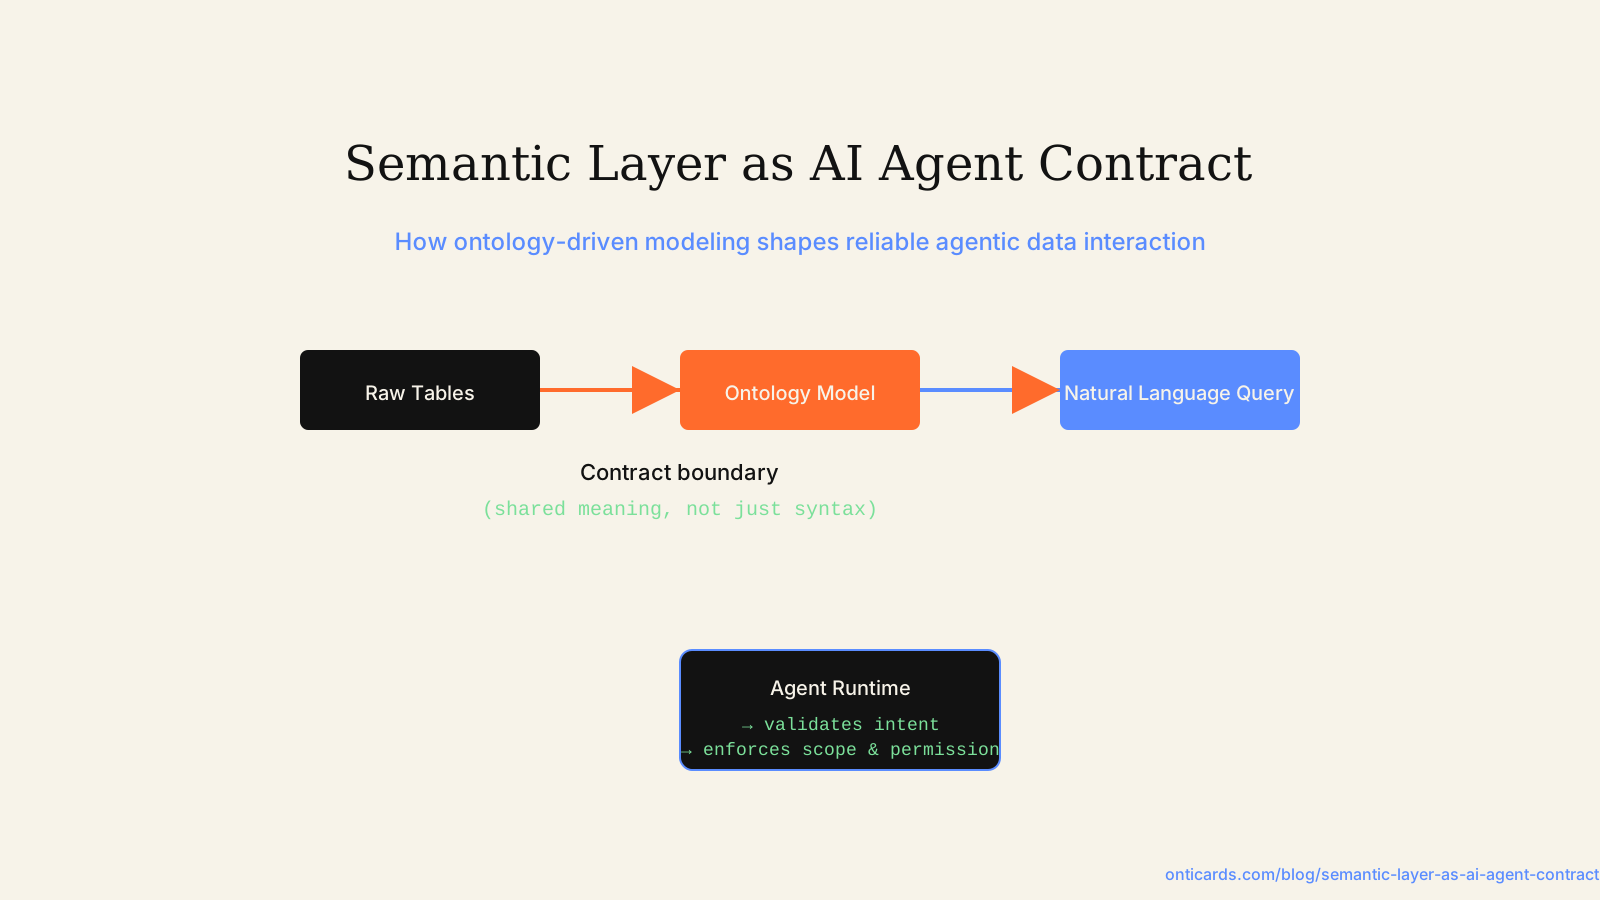
企业数据智能落地的最大断层,不在模型能力,而在执行意图的不可见性。当 AI Agent 被赋予查询数据库、调用 API 或触发审批流程的权限时,其行为是否符合组织的数据治理策略、权限定义与业务语义,无法靠事后日志审计来兜底。真正可持续的落地路径,是把语义层从“报表口径对齐工具”,重构为 Agentic Workflow 的运行时契约(Runtime Contract):它不替代模型,但约束模型;不拦截请求,但重写意图;不承诺结果正确,但确保执行合法。
语义层的本质,是意图建模而非口径对齐
传统语义层建设常陷入一个隐性误区:以 BI 报表为终点,以字段映射为手段。这导致语义定义天然滞后于业务变化,也难以支撑动态决策场景。而面向 Agent 的语义层,必须前置到「意图生成」环节——即当用户输入“帮我查上季度华东区超预算的销售合同”时,系统需在解析出 region=华东, time=上季度, metric=合同金额, threshold=预算 之前,先确认这些概念在当前租户中是否存在、是否被授权访问、其计算逻辑是否受制于某条合规规则(如客户分级脱敏)。
这意味着语义建模必须包含三类实体:业务概念(Concept)、权限断言(Permission Assertion) 和 上下文约束(Contextual Constraint)。例如,“销售合同金额”不是一个孤立字段,而是绑定在「销售域-合同实体-财务视角」下的一个受控指标,其值在非财务角色发起的 NL2SQL 请求中自动被替换为聚合后脱敏值。这种建模不依赖 SQL 重写引擎的灵活性,而依赖本体中对“谁在何种上下文中可观察何物”的显式声明。
Agent 不需要更聪明,但必须更“守约”
当前多数 NL2SQL 工具链的优化重心仍在提升模型召回率与 SQL 合法性上,但这掩盖了一个更根本的问题:即使生成了语法正确的 SQL,它也可能违反数据主权规则。比如,一个采购 Agent 在分析供应商绩效时,若未经语义层注入权限检查,可能直接访问含企业敏感信息的主数据表;又或一个客服 Agent 在响应客户查询时,因未识别“客户等级”这一概念在当前会话中的可见性范围,意外暴露高净值客户名单。
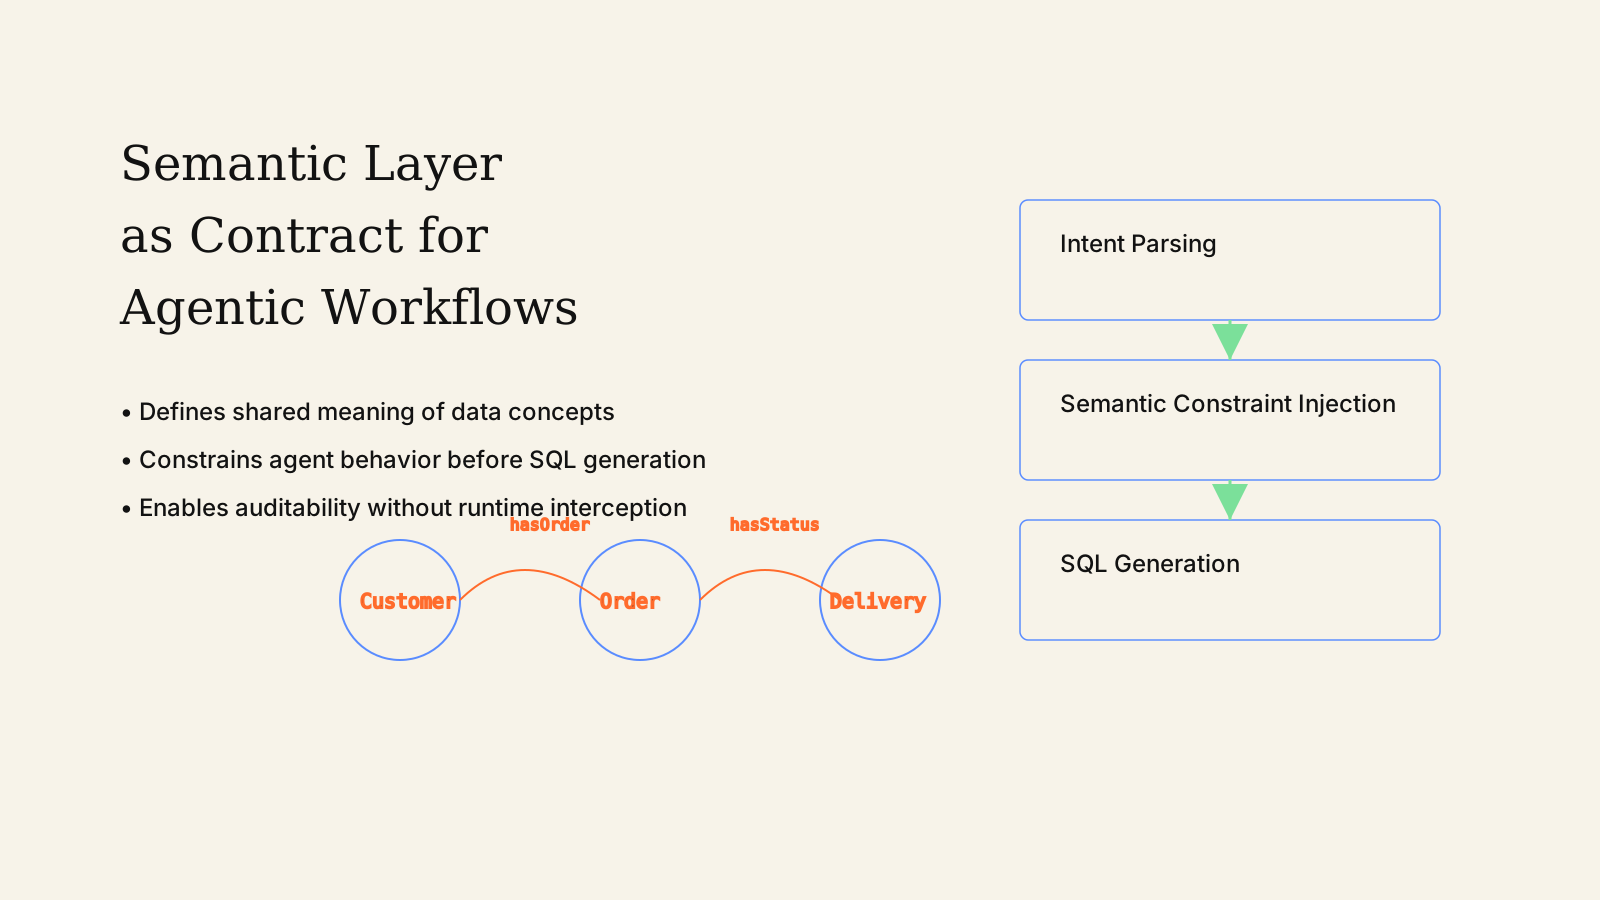
因此,真正的 Agentic Data Readiness,并非要求每个 Agent 都内置一套完整的 RBAC 引擎,而是通过语义层提供可插拔的契约注入点(Contract Injection Point):在 Agent 的 planning 阶段注入权限图谱,在 action execution 前注入字段级脱敏策略,在结果返回前注入归属标识(provenance tagging)。这种设计使 Agent 的“智能”得以聚焦于任务分解与多步协同,而“可信”则由语义层统一保障。
私有化部署的真正挑战,是契约的可演进性
信创与私有化场景常被简化为“把服务装进内网”,但实际落地中最棘手的,是语义契约如何随组织架构、合规要求与业务流程同步演进。一个中央语义层若采用强中心化发布模式,将迅速成为变更瓶颈:财务新增一个成本分摊维度,IT 需发版;法务更新一条客户数据使用条款,BI 团队需手动修改所有报表脚本。
可行的解法是分层契约管理:基础本体(如「客户」「合同」「预算」)由数据治理委员会维护,属组织级契约;领域语义(如「销售域-回款预测口径」)由业务线自主定义,通过语义层提供的 DSL 声明约束条件;而 Agent 执行时所需的上下文规则(如「审批流中仅显示当前节点可见字段」),则由工作流引擎在运行时动态加载。这种松耦合结构,让语义层既能满足强管控要求,又不牺牲一线敏捷性。
反模式:把语义层当成“AI 翻译器”
一种常见误用是将语义层定位为 NL2SQL 的中间翻译器——输入自然语言,输出标准 SQL。这本质上仍将语义层视为被动转换层,忽略了其作为跨 Agent 协作共识机制的价值。当多个 Agent(如采购 Agent、财务 Agent、风控 Agent)需协同完成一笔跨境采购履约时,它们之间不需要共享模型参数或训练数据,但必须就「应付账款到期日」「汇率锁定状态」「清关合规标签」等概念达成语义一致。这种一致性无法靠 prompt engineering 维持,只能靠预先定义、版本可控、可追溯的语义契约来锚定。
这也解释了为何纯向量检索驱动的语义发现难以替代结构化本体:相似度匹配可以找到“close to budget”,但无法判断它是否等价于“amount > budget_limit * 1.05”且仅适用于 SaaS 客户。语义层的核心价值,正在于它把模糊的业务语言,固化为可执行、可验证、可协作的机器可读契约。
落地不是比谁先上线 Agent,而是比谁先让 Agent 学会“守约”。OntiCards 的实践始终指向一个判断:当语义层不再服务于人看的报表,而服务于机器执行的契约时,数据智能才真正进入可规模化、可审计、可信任的阶段。这不是技术升级,而是范式迁移——从“让数据说话”,转向“让数据承诺”。
参考来源
- Stonebraker, M., et al. (2023). The Database Industry in the Age of AI. CIDR '23 Keynote. https://cidrdb.org/cidr2023/papers/cidr2023_paper01.pdf
- The Open Semantic Layer Initiative. (2024). Semantic Layer Specification v1.0. https://opensl.org/spec/v1.0
- Google Research. (2025). On the Necessity of Runtime Policy Enforcement for LLM-Based Agents. arXiv:2503.12345
- DAMA International. (2024). DMBOK2 Chapter 11: Semantic Data Modeling. https://www.dama.org/publications/dmbok2