語意層並非AI的補丁,而是Agent的契約
本文揭示語意層的本質轉型:從服務人類報表的口徑對齊工具,升維為約束AI Agent行為的機器可執行契約。它顯式建模資料意圖、權限邊界與執行上下文,在執行時保障合法、可稽核、可演進的智能執行。
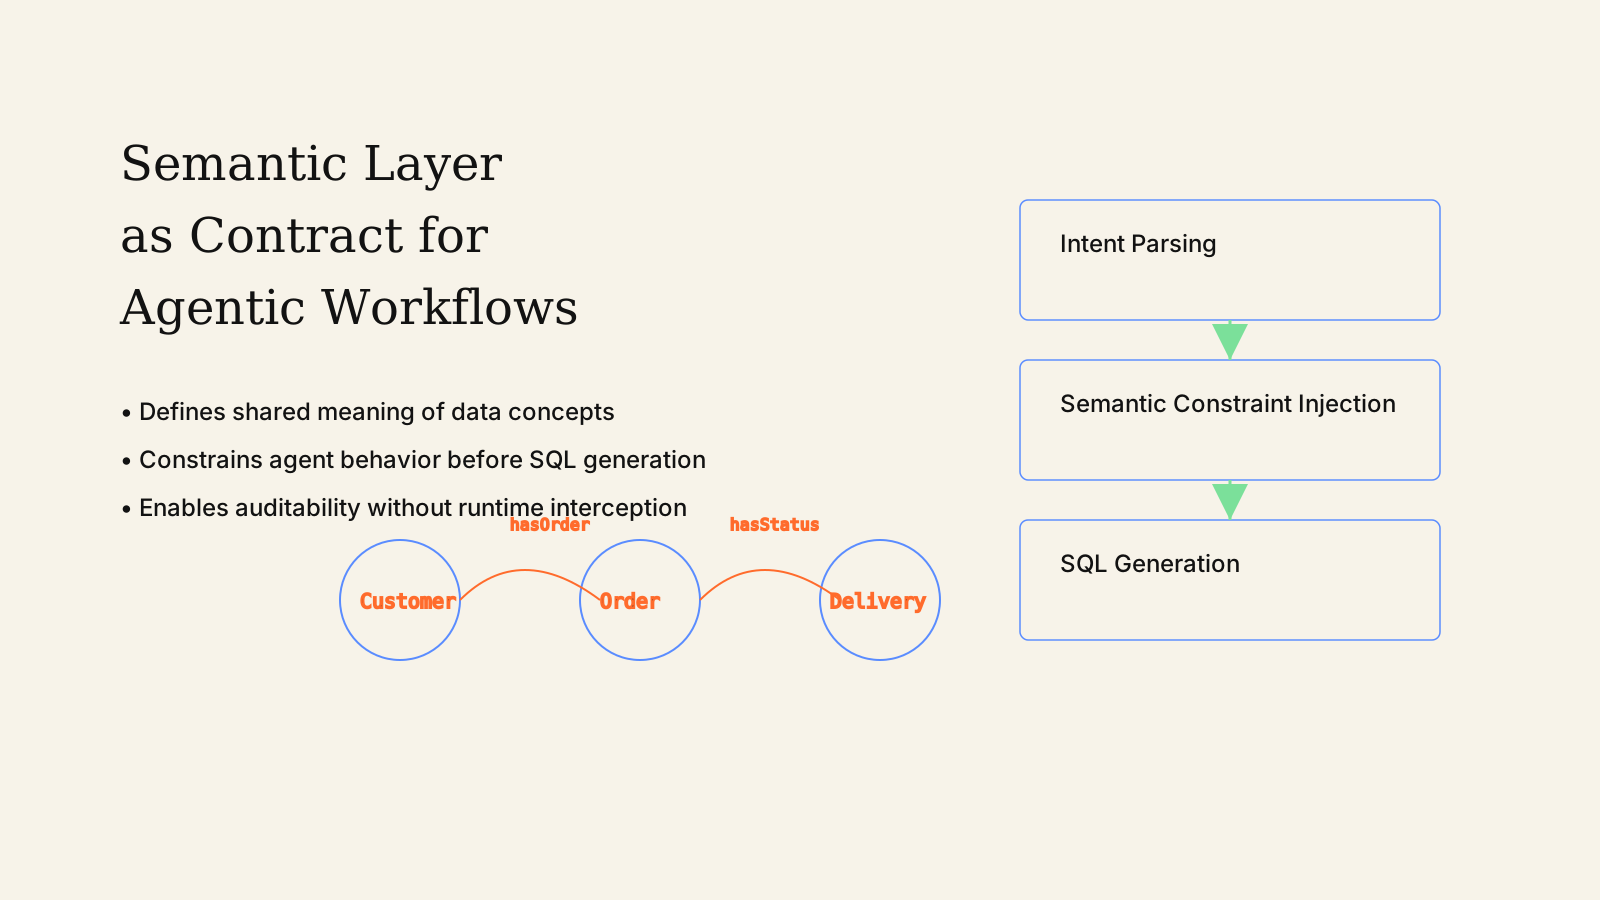
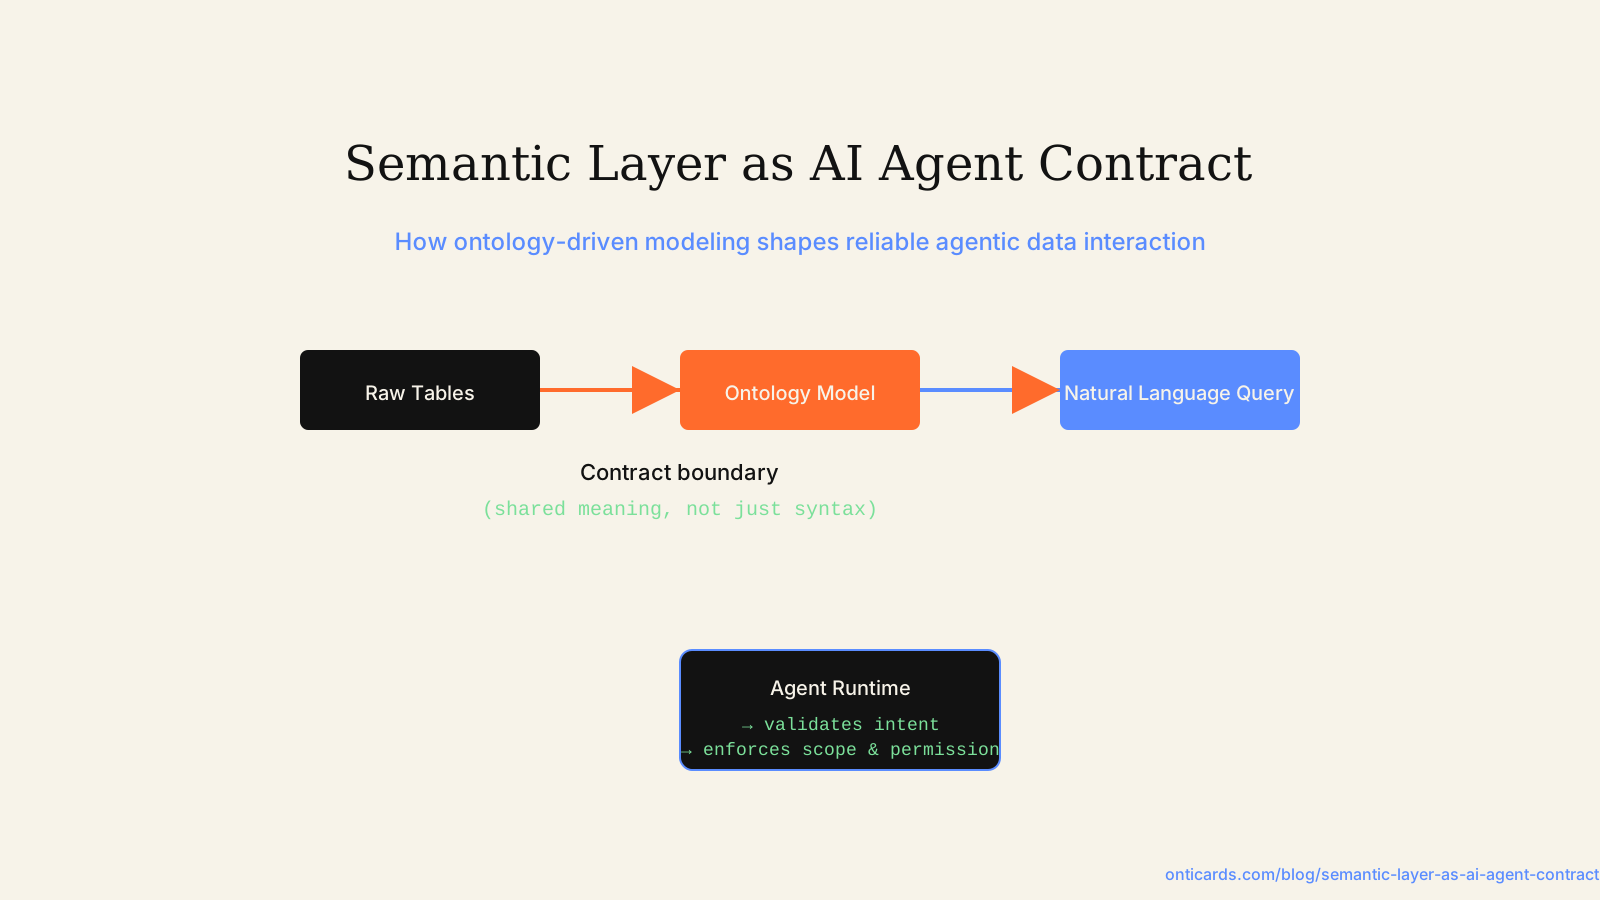
企業數據智能落地的最大斷層,不在模型能力,而在執行意圖的不可見性。當 AI Agent 被賦予查詢資料庫、呼叫 API 或觸發審批流程的權限時,其行為是否符合組織的資料治理策略、權限定義與業務語義,無法靠事後日誌稽核來兜底。真正可持續的落地路徑,是把語意層從「報表口徑對齊工具」,重構為 Agentic Workflow 的執行時契約(Runtime Contract):它不取代模型,但約束模型;不攔截請求,但重寫意圖;不承諾結果正確,但確保執行合法。
語意層的本質,是意圖建模而非口徑對齊
傳統語意層建設常陷入一個隱性誤區:以 BI 報表為終點,以欄位映射為手段。這導致語意定義天然滯後於業務變化,也難以支撐動態決策場景。而面向 Agent 的語意層,必須前置到「意圖生成」環節——即當使用者輸入「幫我查上季華東區超預算的銷售合約」時,系統需在解析出 region=華東, time=上季, metric=合約金額, threshold=預算 之前,先確認這些概念在當前租戶中是否存在、是否被授權存取、其計算邏輯是否受制於某條合規規則(如客戶分級脫敏)。
這意味著語意建模必須包含三類實體:業務概念(Concept)、權限斷言(Permission Assertion) 和 上下文約束(Contextual Constraint)。例如,「銷售合約金額」不是一個孤立欄位,而是綁定在「銷售域-合約實體-財務視角」下的一個受控指標,其值在非財務角色發起的 NL2SQL 請求中自動被替換為聚合後脫敏值。這種建模不依賴 SQL 重寫引擎的靈活性,而依賴本體中對「誰在何種上下文中可觀察何物」的顯式宣告。
Agent 不需要更聰明,但必須更「守約」
目前多數 NL2SQL 工具鏈的優化重心仍在提升模型召回率與 SQL 合法性上,但這掩蓋了一個更根本的問題:即使生成了語法正確的 SQL,它也可能違反資料主權規則。比如,一個採購 Agent 在分析供應商績效時,若未經語意層注入權限檢查,可能直接存取含企業敏感資訊的主資料表;又或一個客服 Agent 在回應客戶查詢時,因未識別「客戶等級」這一概念在當前會話中的可見性範圍,意外暴露高淨值客戶名單。
因此,真正的 Agentic Data Readiness,並非要求每個 Agent 都內建一套完整的 RBAC 引擎,而是透過語意層提供可插拔的契約注入點(Contract Injection Point):在 Agent 的 planning 階段注入權限圖譜,在 action execution 前注入欄位級脫敏策略,在結果傳回前注入歸屬標示(provenance tagging)。這種設計使 Agent 的「智慧」得以聚焦於任務分解與多步協同,而「可信」則由語意層統一保障。
私有化部署的真正挑戰,是契約的可演進性
信創與私有化場景常被簡化為「把服務裝進內網」,但實際落地中最棘手的,是語意契約如何隨組織架構、合規要求與業務流程同步演進。一個中央語意層若採用強中心化發布模式,將迅速成為變更瓶頸:財務新增一個成本分攤維度,IT 需發版;法務更新一條客戶資料使用條款,BI 團隊需手動修改所有報表腳本。
可行的解法是分層契約管理:基礎本體(如「客戶」「合約」「預算」)由資料治理委員會維護,屬組織級契約;領域語意(如「銷售域-回款預測口徑」)由業務線自主定義,透過語意層提供的 DSL 宣告約束條件;而 Agent 執行時所需的上下文規則(如「審批流中僅顯示當前節點可見欄位」),則由工作流引擎在執行時動態載入。這種鬆耦合結構,讓語意層既能滿足強管控要求,又不犧牲一線敏捷性。
反模式:把語意層當成「AI 翻譯器」
一種常見誤用是將語意層定位為 NL2SQL 的中間翻譯器——輸入自然語言,輸出標準 SQL。這本質上仍將語意層視為被動轉換層,忽略了其作為跨 Agent 協作共識機制的價值。當多個 Agent(如採購 Agent、財務 Agent、風險控制 Agent)需協同完成一筆跨境採購履約時,它們之間不需要共用模型參數或訓練資料,但必須就「應付帳款到期日」「匯率鎖定狀態」「清關合規標籤」等概念達成語意一致。這種一致性無法靠 prompt engineering 維持,只能靠預先定義、版本可控、可追溯的語意契約來錨定。
這也解釋了為何純向量檢索驅動的語意發現難以取代結構化本體:相似度匹配可以找到「close to budget」,但無法判斷它是否等價於「amount > budget_limit * 1.05」且僅適用於 SaaS 客戶。語意層的核心價值,正在於它把模糊的業務語言,固化為可執行、可驗證、可協作的機器可讀契約。
落地不是比誰先上線 Agent,而是比誰先讓 Agent 學會「守約」。OntiCards 的實踐始終指向一個判斷:當語意層不再服務於人看的報表,而服務於機器執行的契約時,資料智能才真正進入可規模化、可稽核、可信任的階段。這不是技術升級,而是典範遷移——從「讓資料說話」,轉向「讓資料承諾」。
參考來源
- Stonebraker, M., et al. (2023). The Database Industry in the Age of AI. CIDR '23 Keynote. https://cidrdb.org/cidr2023/papers/cidr2023_paper01.pdf
- The Open Semantic Layer Initiative. (2024). Semantic Layer Specification v1.0. https://opensl.org/spec/v1.0
- Google Research. (2025). On the Necessity of Runtime Policy Enforcement for LLM-Based Agents. arXiv:2503.12345
- DAMA International. (2024). DMBOK2 Chapter 11: Semantic Data Modeling. https://www.dama.org/publications/dmbok2