本体成为战略战场:语义层一个月从 95% 衰减到 65%
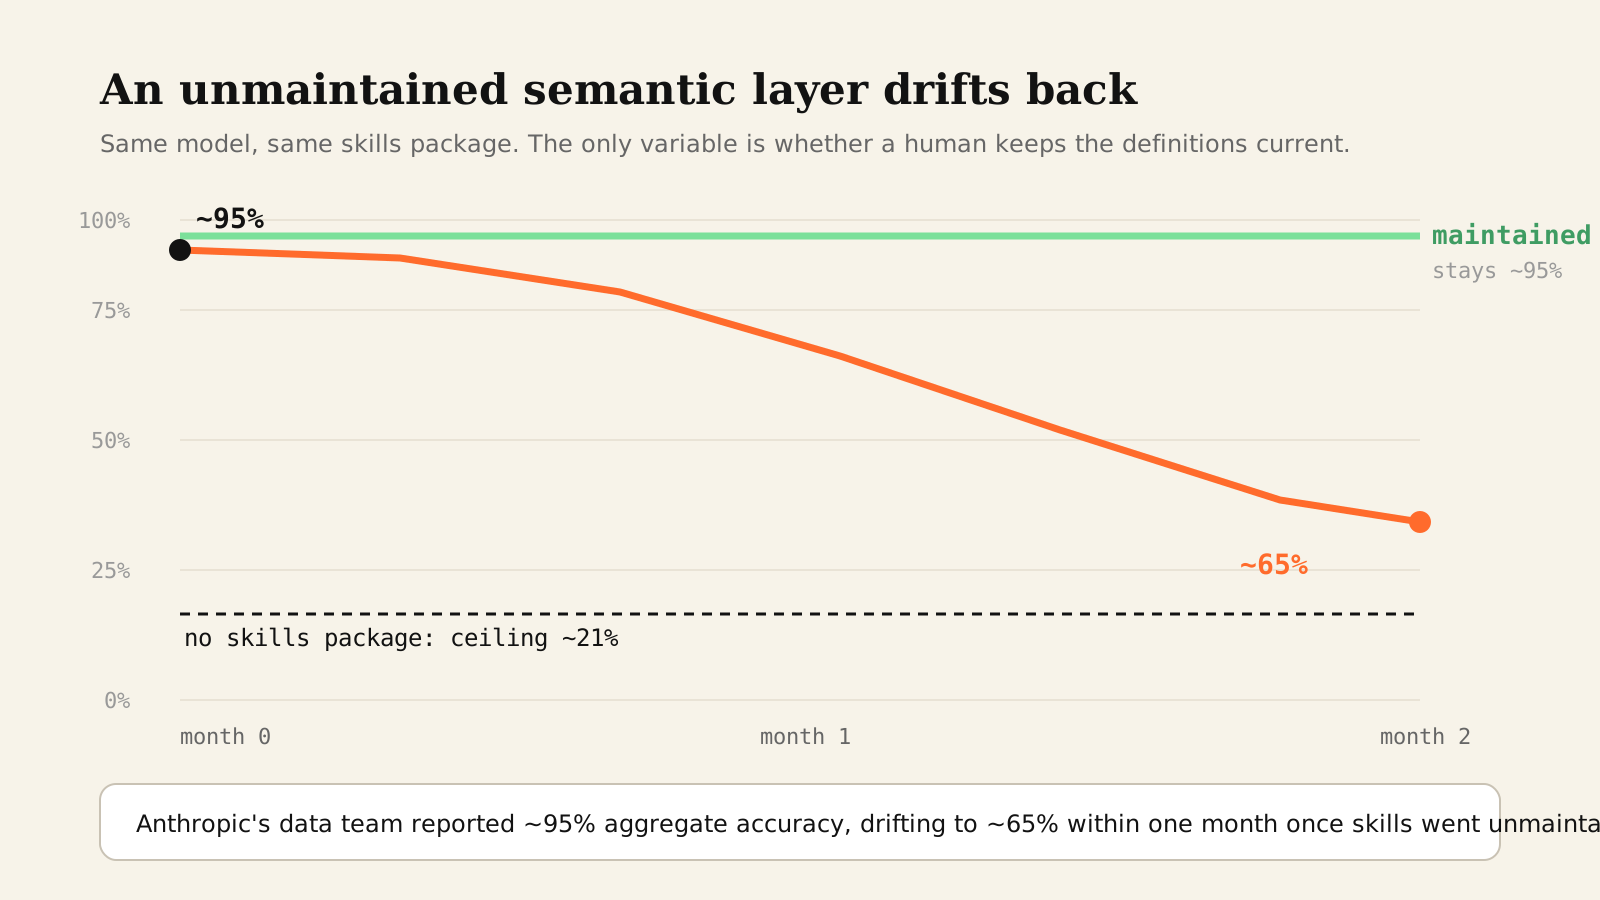
问数智能体的准确率,不取决于模型,而取决于语义层有没有人维护。Anthropic 数据团队的复盘显示,技能缺维护时离线准确率一个月内从约 95% 掉到约 65%;同一周,Constellation 把数据本体列为厂商竞争的战略战场。
企业问数智能体的准确率,主要不是被模型决定的,而是被一件事决定的:语义层有没有人持续维护。 Anthropic 数据团队公开的内部复盘里有一个很少被引用的数字——当技能(Skill,即引导智能体按什么顺序查什么资料的流程说明)缺少维护时,离线准确率在一个月内从约 95% 下降到约 65%。
同一周,Constellation Research 在给企业买家的建议里,把「数据本体」(ontology,即企业业务概念及其关系的显式定义)直接列为 AI 平台的战略战场。
两个信号指向同一件事:语义层与本体不是一次性的交付物,而是会随时间衰减的资产。
一、船已经开了:智能体正在成为企业数据的默认消费者
先看规模。据 AIUseCaseHub 截至 2026 年 10 月 11 日的统计,在其归档的 3,891 条企业 AI 部署中,有 1,114 条属于智能体部署,其中 420 条是多智能体;智能体占新发布部署的比例从 2022 年一季度的 7% 升到 2026 年三季度的 22%,三年多涨了 3.3 倍。
Gartner 的预测更直接:到 2028 年,三分之一的企业软件将包含 Agentic AI,而 2025 年这个比例还不到 1%。 麦肯锡面向近 2,000 名企业员工的调研显示,23% 的受访企业已在部分业务场景规模化应用 Agent,另有 39% 处于试验阶段。
数据消费的主体从「人」换成「智能体」,带来一个不容易察觉的后果:过去靠人的经验和常识兜住的口径歧义,现在没人兜了。分析师能凭经验判断「这里的收入应该用含税口径」,智能体不能——它只会挑一个看起来最像的字段。
二、给它更多数据,为什么没用
Anthropic 把数据分析的难点归为三类,而不是「SQL 写得对不对」:
| 失败模式 | 具体表现 | 典型后果 |
|---|---|---|
| 概念与实体歧义 | 「活跃用户」能对上几十种字段与过滤组合,智能体不知道提问者指哪一种 | 数字看着合理,口径是错的 |
| 数据与语义过期 | 数据源、业务定义、表结构每天在变,智能体记住的认知在几周内失效 | 结论在不知不觉中偏掉 |
| 检索失败 | 正确的表其实存在且已标注,但搜索空间太大,智能体就是找不到 | 用错的表回答了问题 |
最反直觉的一组证据来自他们的消融实验:团队把整个仪表盘、数据转换和数据分析师笔记本的 SQL 语料库(数千个文件)直接开放给智能体做全文检索,并确认它在每次回答前确实读了这些文件——准确率的变化不到一个百分点。更关键的是,在答错的题目里,约 80% 的答案其实就在语料库中,「答案在场」并不能预测「这一次能答对」。
中文侧的口径一致。爱分析在《2026 爱分析·Data+AI 应用实践报告》中复核这个案例时写道:直接向 Agent 开放数千份历史 SQL,对准确率的提升不足一个百分点,资料数量无法替代结构化的数据导航。
另一个方向的证据同样清晰。我们也曾在真实企业库上的问数实测里看到同一个规律:决定答案对错的,是提问有没有落到正确的实体上。dbt Labs 2026 年的基准测试(ACME Insurance 11 道题、每题跑 20 次)显示,同一个模型走语义层与走纯 text-to-SQL,差距是两位数的百分点:Claude Sonnet 4.6 从 90.0% 提升到 98.2%,GPT-5.3 Codex 从 84.1% 提升到 100%。报告里有一句判断值得抄下来:当语义层能回答一个问题时,它一定答对;当它不能时,它会告诉你——它不会悄悄返回错误数据。
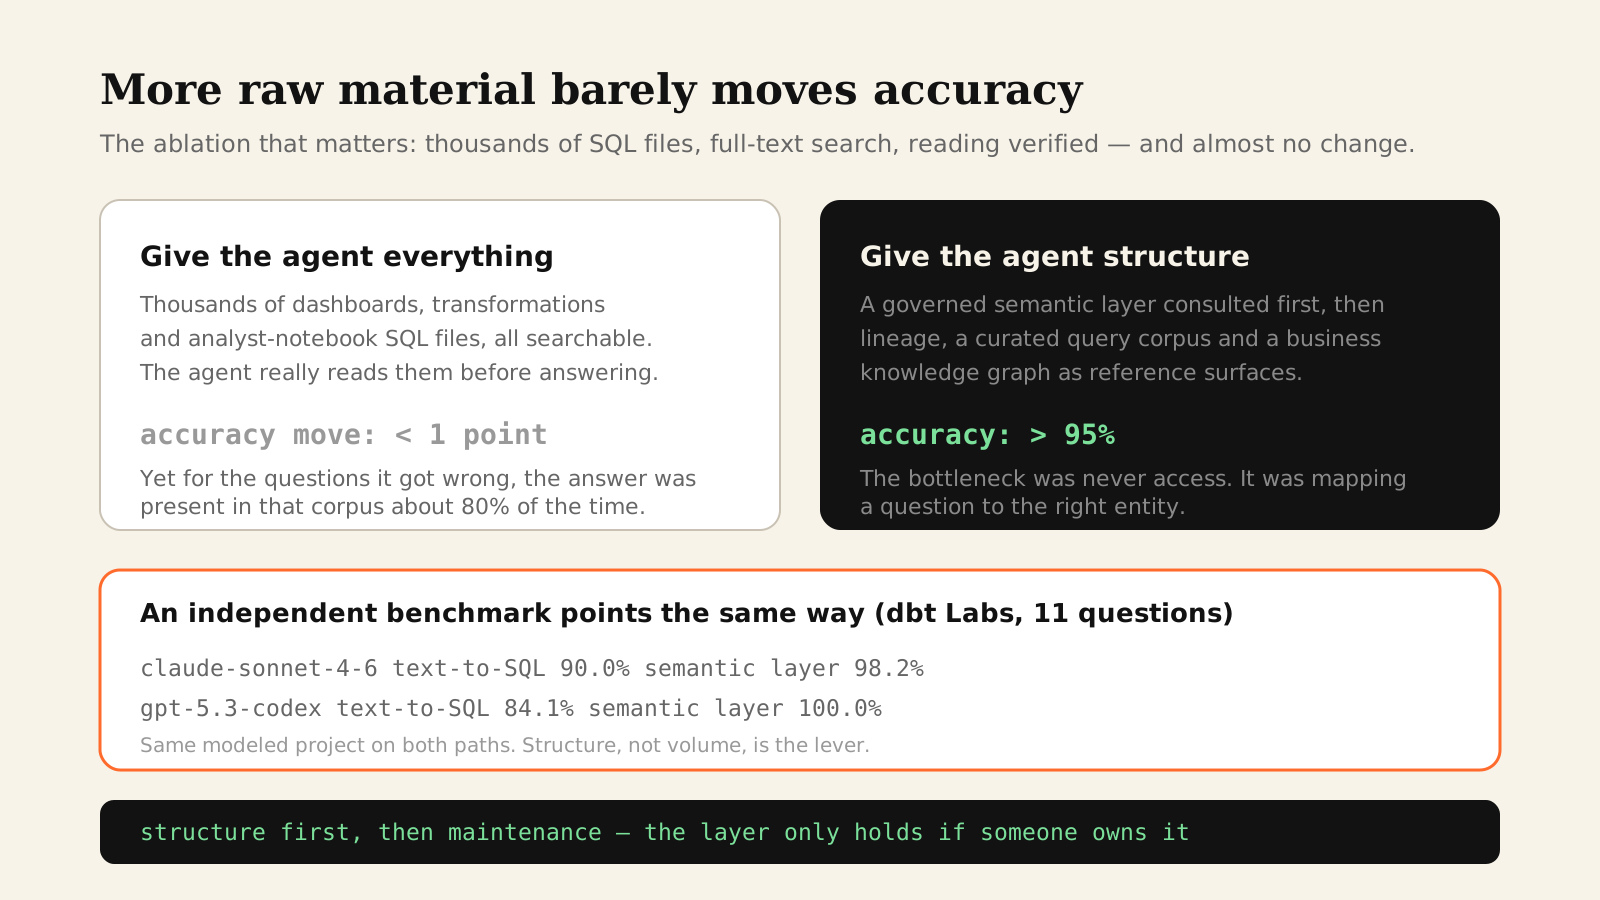
结构比访问权更重要,这是两套独立证据得出的同一个结论。而结构能否长期有效,取决于维护。
三、本体挤进厂商的战略清单
2026 年 10 月,Constellation Research 把「语义与上下文管理」单独立为一个评估品类(2026 ShortList),在 20 多个方案里只选出 8 个。它给企业买家的建议值得逐字读:为每个新 AI 用例定制语义、定制检索、定制策略逻辑,会堆出一笔「数据债与返工」。 因此领先的数据与 AI 负责人正在做「低后悔」的选择——在定义、关系、策略、接口上少动刀,把资源先花在可移植性上,等待这个市场稳定。
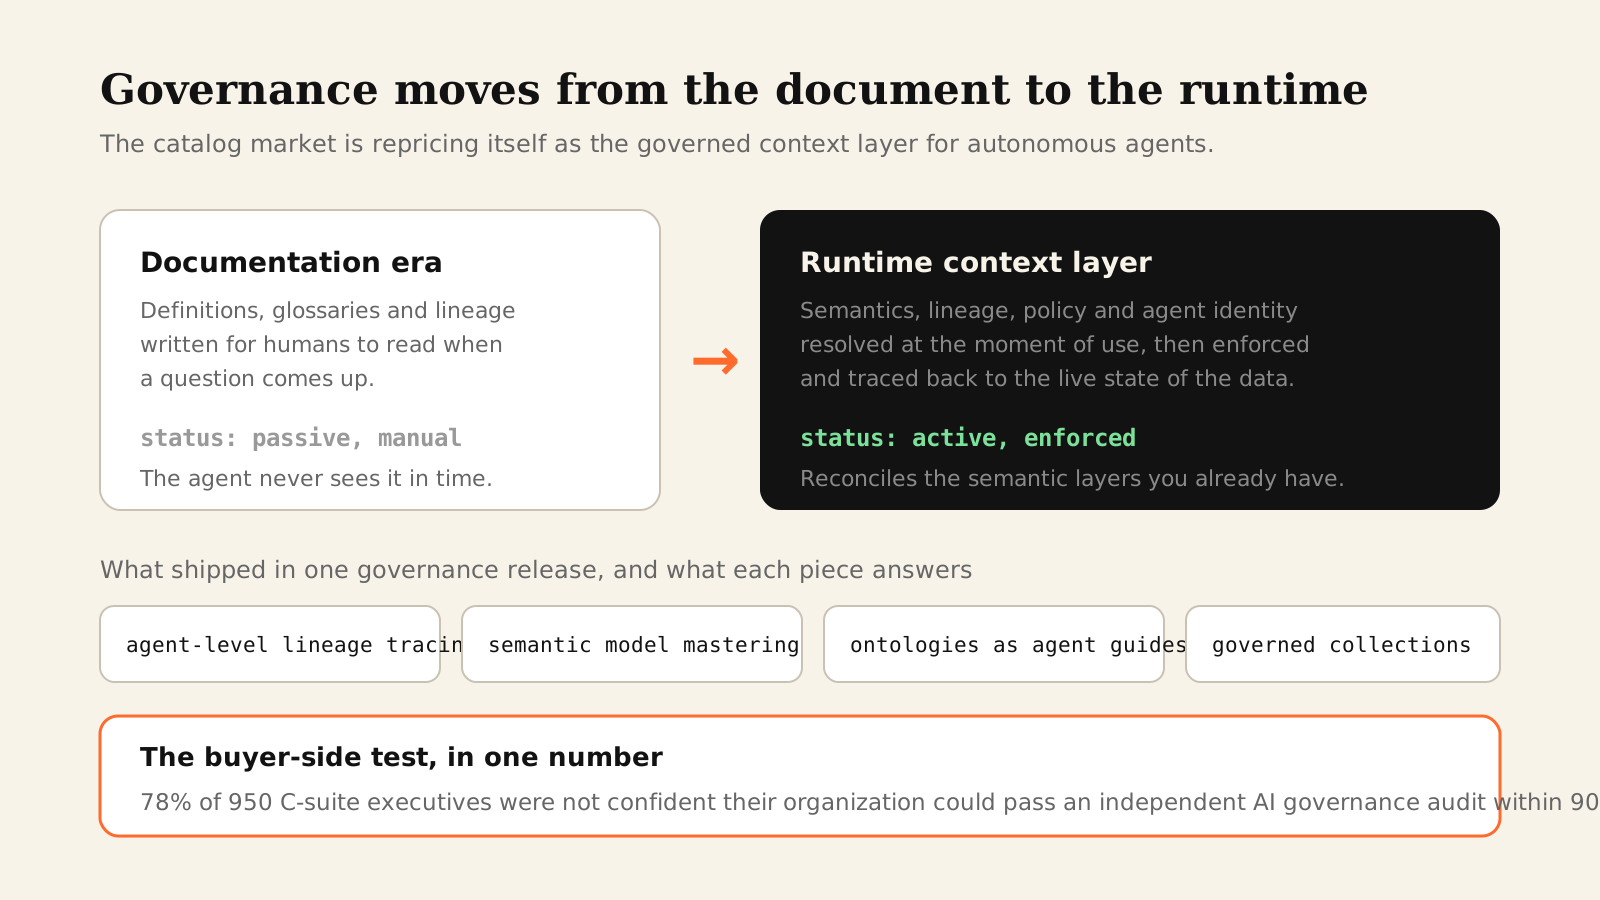
同一时间,数据目录厂商的路线变化也很明显。Alation 在 revAlation 大会上发布六件套(AI Governance、Ontologies、Intelligent Feeds、Console、Governed Collections、Semantic Model Mastering),分析师的评价是:治理从「给人类看的被动文档」,变成了「面向企业数据、上下文与智能体的运行时强制执行系统」。其中两个细节与今天的话题直接相关:
- Semantic Model Mastering 不复造语义层,而是调和既有的语义层:从 Databricks 与 Snowflake 摄取语义模型,在 Alation 里治理、补全,再同步回原平台。目标是让「活跃客户」这类概念在下游所有分析与智能体里只有一个定义,而不必让每个团队各自重做一遍治理。
- Ontologies 把业务规则从「让智能体猜」变成「显式定义」:关系、约束、业务逻辑先由领域专家评审,再映射到数据目录,并以开放标准导出,供不同的智能体运行时使用。
同一份材料里还有一个更扎眼的数字:Grant Thornton 2026 年对 950 位高管的调研显示,78% 的高管没有把握自己的组织能在 90 天内通过一次独立的 AI 治理审计。
爱分析给企业的路径则更务实:不必推倒既有的数据治理体系,而是补齐四件事——核心业务概念对应权威数据来源;数据携带业务语义与使用说明;数据和知识以可调用的方式(语义层、指标平台、数据服务、知识库)提供给智能体;调用过程支持追溯与更新。注意最后一条:不是「建好就行」,而是「能追、能改」。
四、把本体当资产来管:四个动作
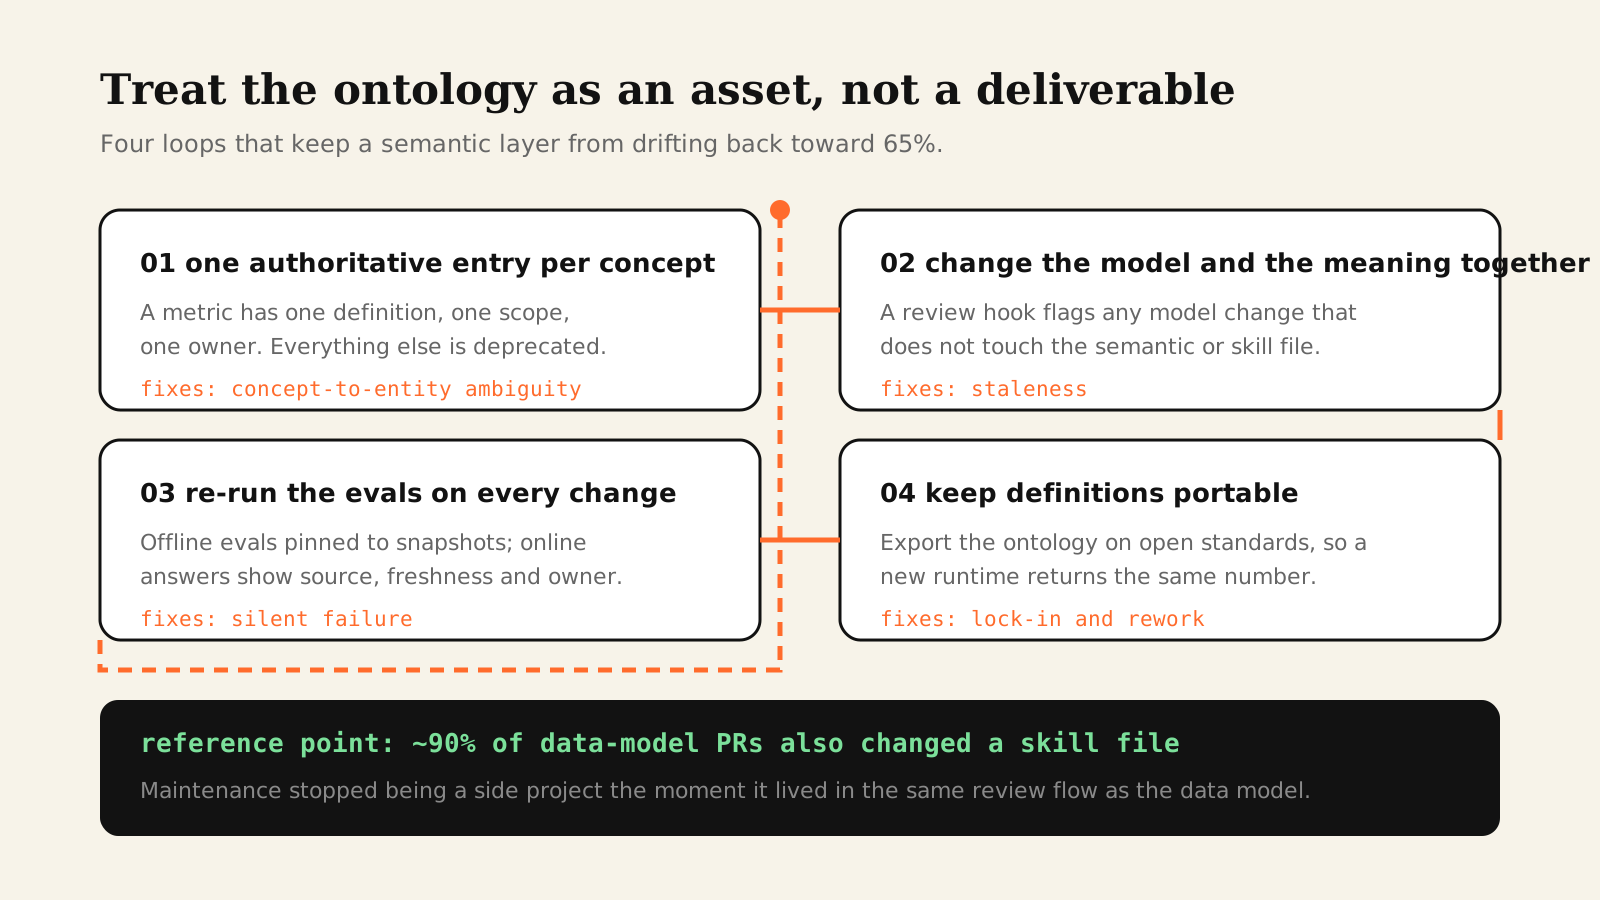
| 动作 | 治的是哪一类失败 | 可验收的检查点 |
|---|---|---|
| ① 每个业务概念只有一个权威入口 | 概念与实体歧义 | 能否说出某个指标的负责人与适用范围 |
| ② 数据模型变更与语义变更同批提交 | 数据与语义过期 | 数据模型的合并请求里是否同时动了语义或技能文件 |
| ③ 评测随变更重跑,线上展示来源 | 检索失败与静默失败 | 结论能否附上来源、口径与更新时间 |
| ④ 定义与实现保持可移植 | 供应商锁定与返工 | 换一个智能体运行时,同一个问题是否同一个答案 |
第二项有个可量化的参照:Anthropic 把语义与技能的维护直接并进数据工程流程——审查钩子会标记任何没有同步改动技能文件的数据模型变更,最终约 90% 的数据模型合并请求,在同一个 diff 里包含了技能变更。维护之所以能坚持下来,是因为它和改表躺在同一条评审流水线上。
第三项则承认了边界。他们的线上监控保留对抗性审查(准确率 +6%,但词元消耗 +32%、延迟 +72%),并明确「高准确率不等于消除错误」:静默失败仍会发生,所以提交给管理层的结论保留人工确认,普通答案则统一带上来源可信层级、数据新鲜度和责任人。
结语
这一周真正的变化,不是某个模型又强了多少,而是企业第一次需要为「业务含义」这件事配一个所有者:谁来定义它,谁在数据模型变化时同步它,谁在它失效时发现它。
没有维护流程的本体,只是一份写得很好的文档——而文档不会自己保持正确。在 OntiCards 的四层架构里,这件事落在语义卡片层:每个业务概念对应一张带语义、带查询范围、带敏感级、带负责人的数据卡片,数据模型变更与卡片变更走同一条审核路径,智能体只能在这些卡片划定的边界内取数——这也是为什么本体图记忆比把历史 SQL 全塞给模型更可靠。想看看卡片体系具体长什么样,可以从产品页开始;如果你们正在做问数类试点、发现口径越用越乱,也欢迎写信到 hello@onticards.com 聊聊你们的场景。