本體成為戰略戰場:語義層一個月由 95% 跌到 65%
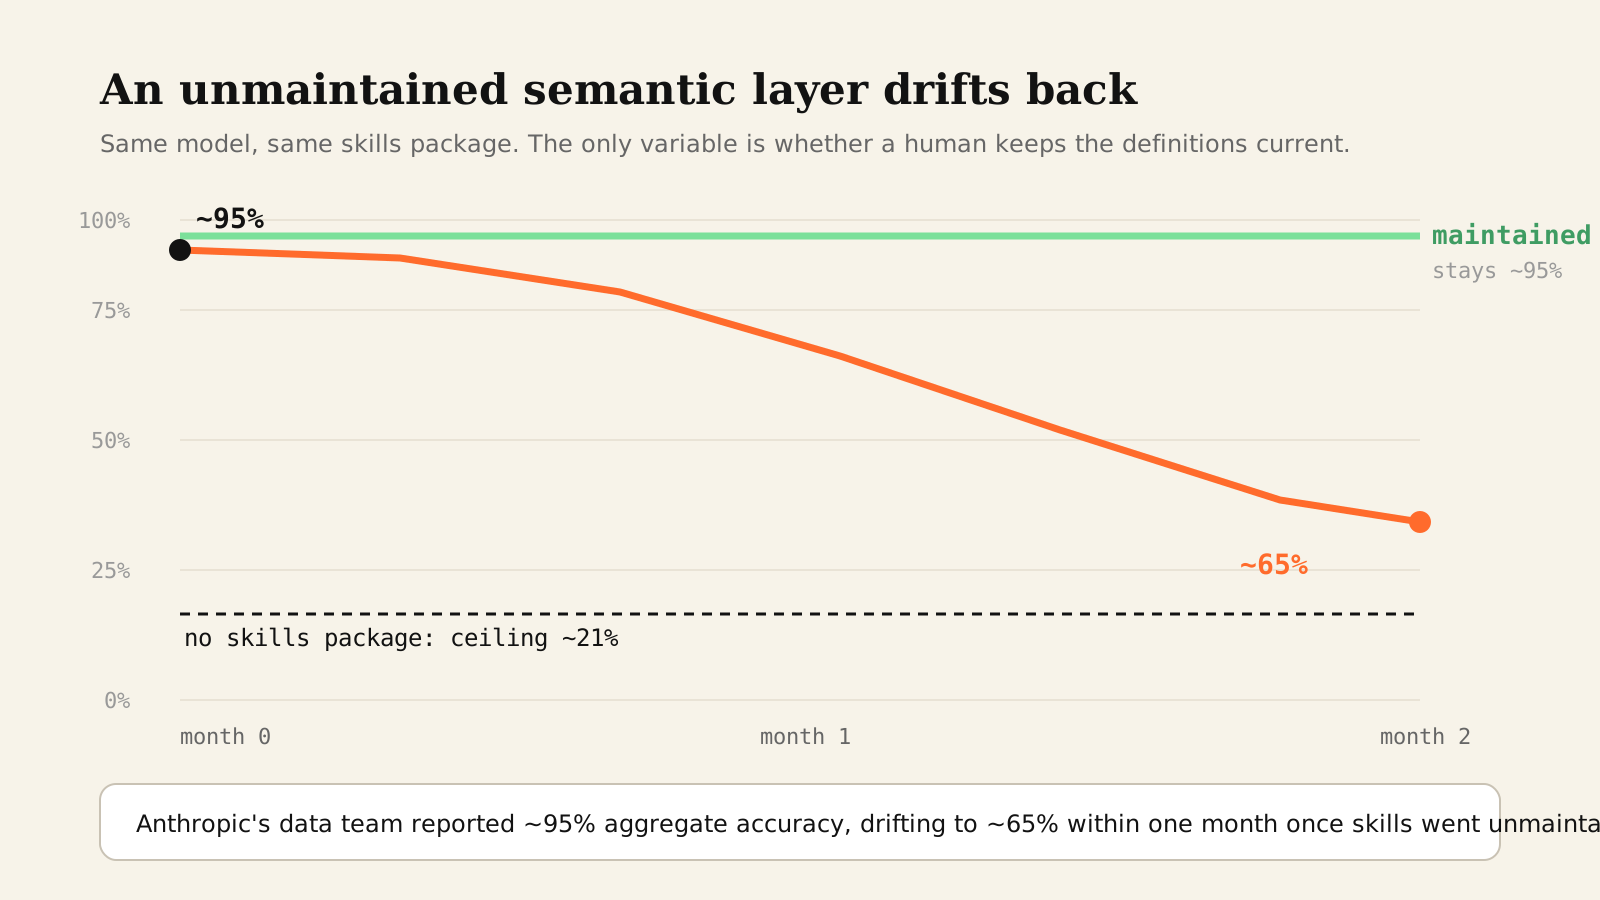
問數智能體嘅準確率,唔係取決於模型,而係取決於語義層有冇人維護。Anthropic 數據團隊嘅復盤顯示,技能冇人維護時,離線準確率一個月內由約 95% 跌到約 65%;同一星期,Constellation 將數據本體列為廠商競爭嘅戰略戰場。
企業問數智能體嘅準確率,主要唔係畀模型決定,而係畀一件事決定:語義層有冇人持續維護。 Anthropic 數據團隊公開嘅內部復盤裏面,有一個好少人引用嘅數字——當技能(Skill,即引導智能體按咩次序查咩資料嘅流程說明)冇人維護嘅時候,離線準確率喺一個月內由約 95% 跌到約 65%。
同一個星期,Constellation Research 喺畀企業買家嘅建議裏面,直接將「數據本體」(ontology,即企業業務概念同佢哋之間關係嘅顯式定義)列為 AI 平台嘅戰略戰場。
兩個信號指向同一件事:語義層同本體唔係一次性嘅交付物,而係會隨時間衰減嘅資產。
一、船已經開咗:智能體正成為企業數據嘅預設消費者
先睇規模。據 AIUseCaseHub 截至 2026 年 10 月 11 日嘅統計,喺佢歸檔嘅 3,891 條企業 AI 部署入面,有 1,114 條屬於智能體部署,其中 420 條係多智能體;智能體佔新發佈部署嘅比例,由 2022 年第一季嘅 7% 升到 2026 年第三季嘅 22%,三年多升咗 3.3 倍。
Gartner 嘅預測更直接:到 2028 年,三分一企業軟件會包含 Agentic AI,而 2025 年呢個比例仲未夠 1%。 麥肯錫訪問近 2,000 名企業員工嘅調研顯示,23% 嘅受訪企業已經喺部分業務場景規模化應用 Agent,另有 39% 處於試驗階段。
數據消費嘅主體由「人」換成「智能體」,帶嚟一個唔容易察覺嘅後果:以前靠人嘅經驗同常識兜住嘅口徑歧義,而家冇人兜。分析師可以憑經驗判斷「呢度嘅收入應該用含稅口徑」,智能體唔得——佢只會揀一個睇落最似嘅欄位。
二、畀佢更多數據,點解冇用
Anthropic 將數據分析嘅難點歸為三類,而唔係「SQL 寫得啱唔啱」:
| 失敗模式 | 具體表現 | 典型後果 |
|---|---|---|
| 概念同實體歧義 | 「活躍用戶」可以對上幾十種欄位同過濾組合,智能體唔知提問者指邊一種 | 數字睇落合理,口徑係錯嘅 |
| 數據同語義過期 | 數據源、業務定義、表結構日日變,智能體記住嘅認知幾星期內失效 | 結論喺不知不覺間偏咗 |
| 檢索失敗 | 正確嘅表其實存在而且已經標註,但搜索空間太大,智能體就係搵唔到 | 用錯嘅表答咗個問題 |
最反直覺嘅一組證據嚟自佢哋嘅消融實驗:團隊將整個儀表板、數據轉換同數據分析師筆記本嘅 SQL 語料庫(幾千個檔案)直接開放畀智能體做全文檢索,並確認佢每次答之前真係讀過呢啲檔案——準確率嘅變動唔夠一個百分點。更關鍵嘅係,喺答錯嘅題目裏面,約 80% 嘅答案其實就喺語料庫之中,即係「答案在場」並唔能夠預測「今次答得中」。
中文側嘅口徑一致。愛分析喺《2026 愛分析·Data+AI 應用實踐報告》復核呢個案例時寫道:直接向 Agent 開放幾千份歷史 SQL,對準確率嘅提升不足一個百分點,資料數量無法替代結構化嘅數據導航。
另一個方向嘅證據同樣清晰。我哋亦喺真實企業庫上嘅問數實測見到同一條規律:決定答案對錯嘅,係提問有冇落到正確嘅實體上。dbt Labs 2026 年嘅基準測試(ACME Insurance 11 條題目、每條跑 20 次)顯示,同一個模型行語義層同行純 text-to-SQL,差距係兩位數百分點:Claude Sonnet 4.6 由 90.0% 升到 98.2%,GPT-5.3 Codex 由 84.1% 升到 100%。報告裏面有一句判斷值得抄低:當語義層答得到一條問題,佢一定答得啱;當佢答唔到,佢會話你知——佢唔會靜靜雞回一個錯誤數據。
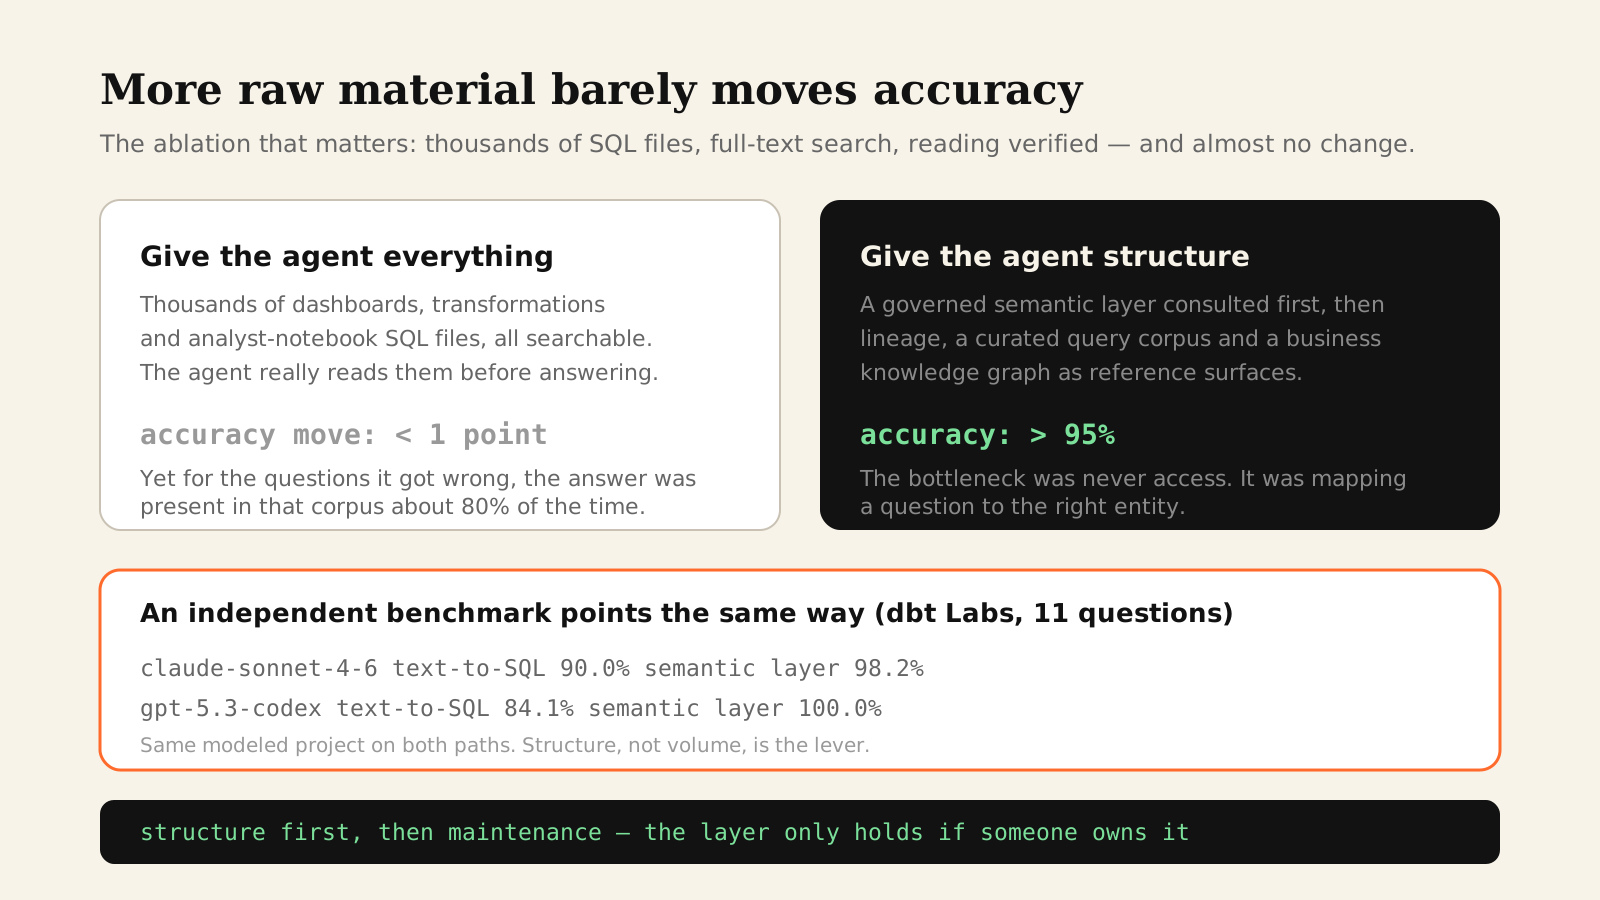
結構比存取權更重要,呢個係兩套獨立證據得出嘅同一個結論。而結構能唔能夠長期有效,就取決於維護。
三、本體擠進廠商嘅戰略清單
2026 年 10 月,Constellation Research 將「語義同上下文管理」單獨立為一個評估品類(2026 ShortList),喺 20 幾個方案裏面只揀出 8 個。佢畀企業買家嘅建議值得逐字讀:為每個新 AI 用例訂造語義、訂造檢索、訂造策略邏輯,會積落一筆「數據債同返工」。 所以領先嘅數據同 AI 負責人正做「低後悔」嘅選擇——喺定義、關係、策略、介面上少動刀,將資源先放喺可移植性上,等呢個市場穩定落嚟。
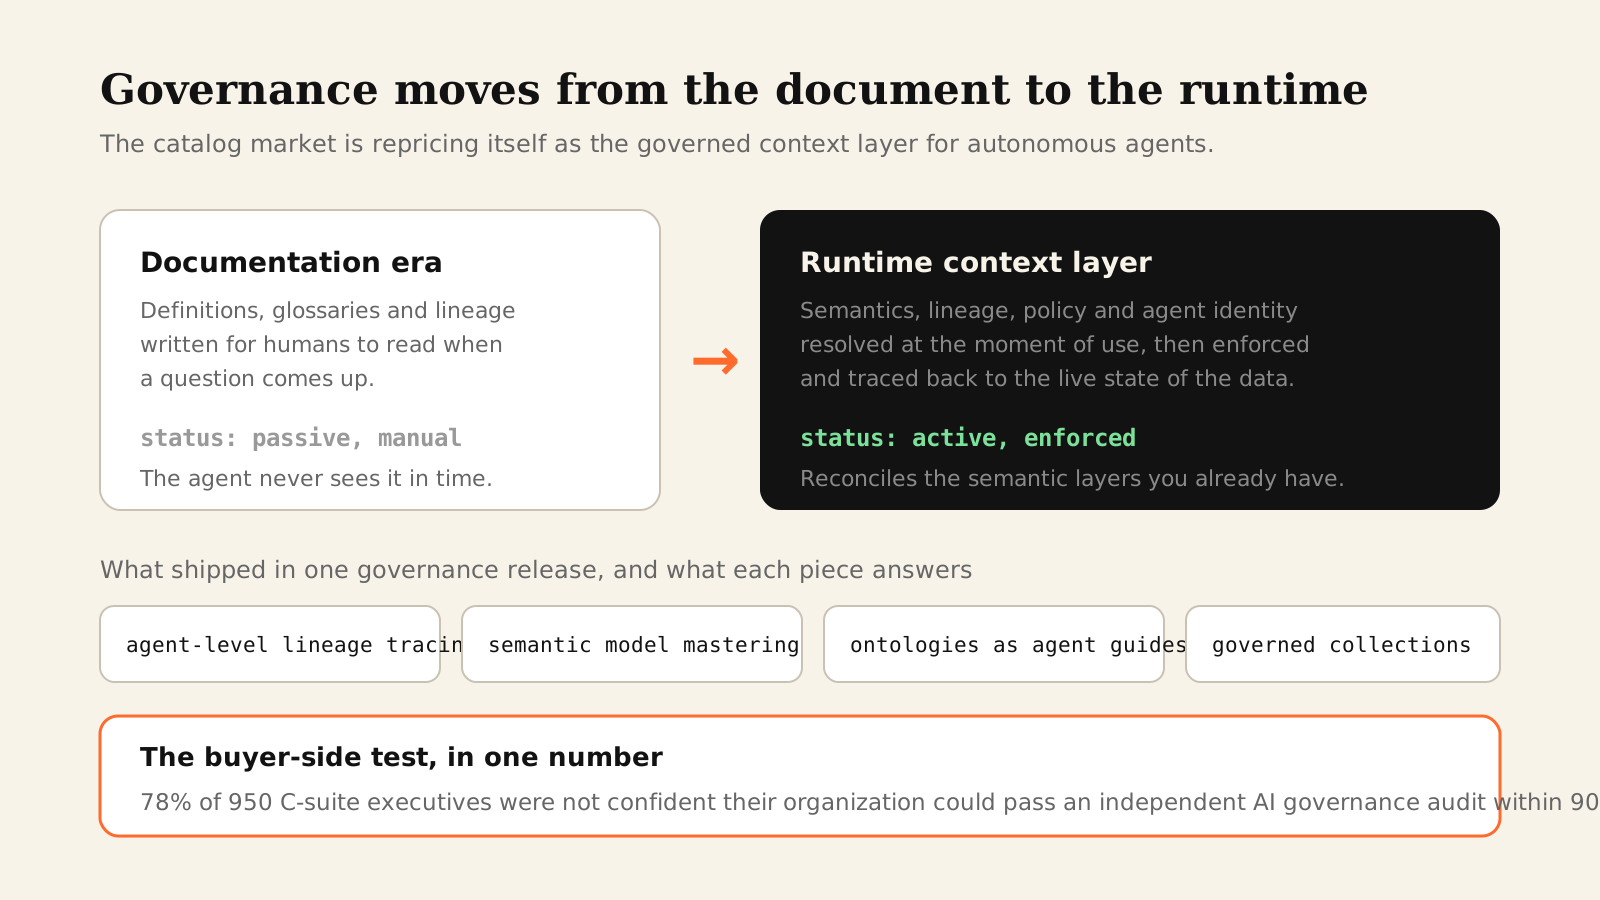
同一時間,數據目錄廠商嘅路線變化都好明顯。Alation 喺 revAlation 大會發佈六件套(AI Governance、Ontologies、Intelligent Feeds、Console、Governed Collections、Semantic Model Mastering),分析師嘅評價係:治理由「畀人類睇嘅被動文件」,變成「面向企業數據、上下文同智能體嘅運行時強制執行系統」。其中兩個細節同今日嘅話題直接相關:
- Semantic Model Mastering 唔係重新造一個語義層,而係調和現有嘅語義層:由 Databricks 同 Snowflake 攝取語義模型,喺 Alation 裏面治理、補全,再同步返原平台。目標係令「活躍客戶」呢類概念,喺下游所有分析同智能體裏面只有一個定義,唔需要每個團隊各自再做一次治理。
- Ontologies 將業務規則由「畀智能體估」變成「顯式定義」:關係、約束、業務邏輯先由領域專家評審,再映射到數據目錄,並以開放標準導出,畀唔同嘅智能體運行時使用。
同一份材料裏面仲有一個更刺眼嘅數字:Grant Thornton 2026 年對 950 位高管嘅調研顯示,78% 嘅高管冇把握自己嘅組織可以喺 90 日內通過一次獨立嘅 AI 治理審計。
愛分析畀企業嘅路徑就務實啲:唔需要推倒既有嘅數據治理體系,而係補齊四件事——核心業務概念對應權威數據來源;數據攜帶業務語義同使用說明;數據同知識以可調用嘅方式(語義層、指標平台、數據服務、知識庫)提供畀智能體;調用過程支援追溯同更新。留意最後一條:唔係「建好就得」,而係「追得到、改得到」。
四、將本體當資產嚟管:四個動作
| 動作 | 治邊一類失敗 | 可驗收嘅檢查點 |
|---|---|---|
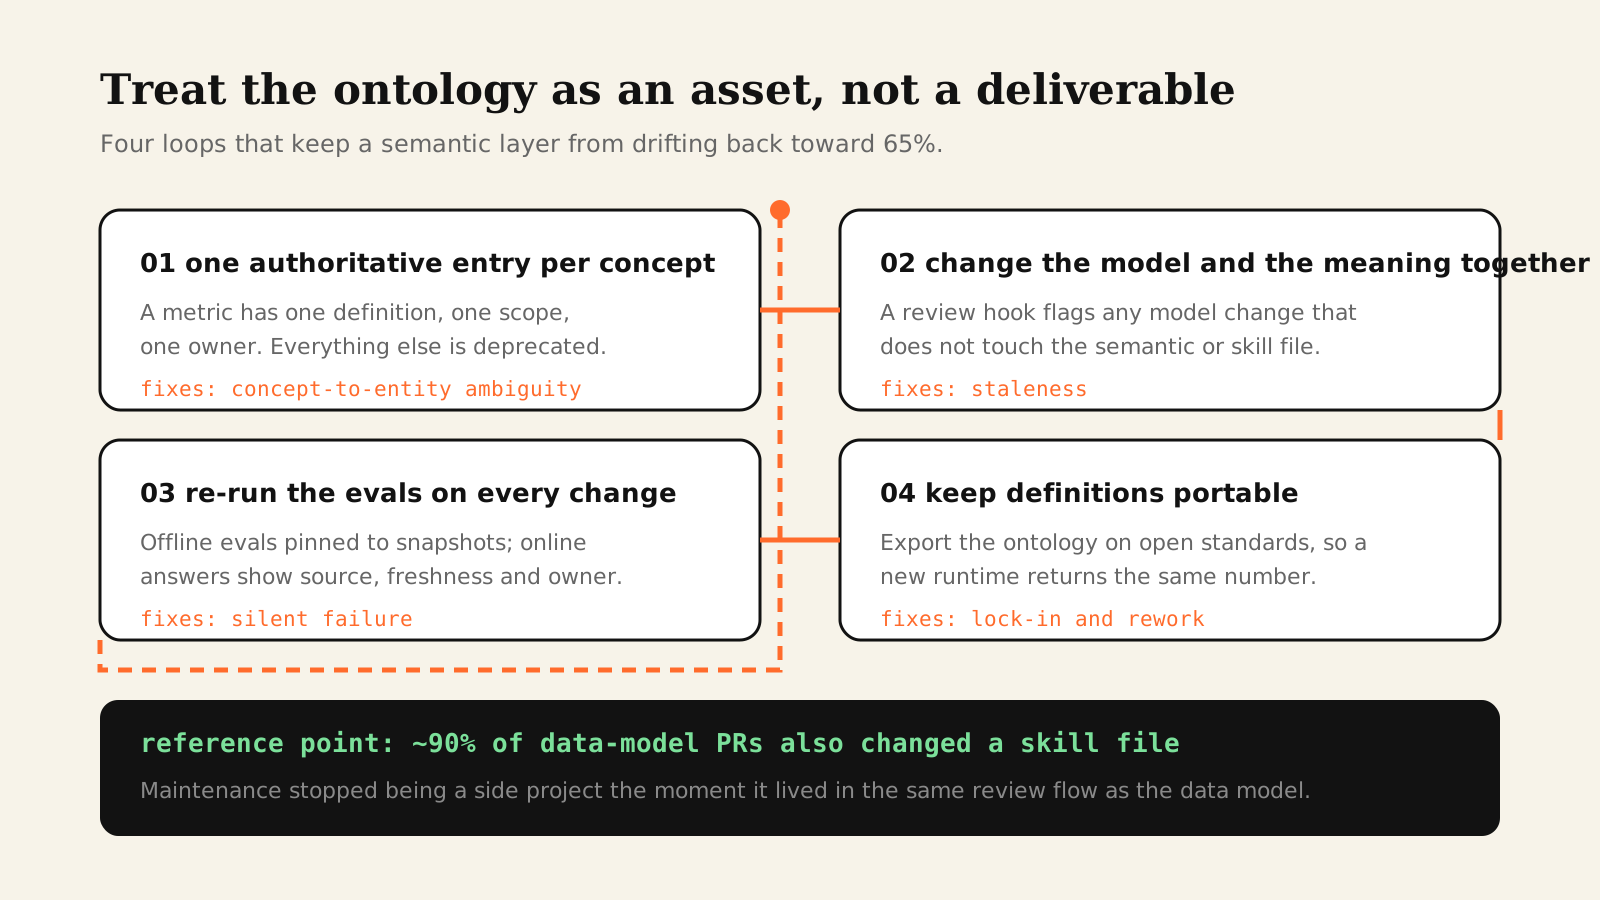
| ① 每個業務概念只有一個權威入口 | 概念同實體歧義 | 講唔講得出某個指標嘅負責人同適用範圍 |
| ② 數據模型變更同語義變更同一批提交 | 數據同語義過期 | 數據模型嘅合併請求有冇同時改動語義或技能檔案 |
| ③ 評測隨變更重跑,線上展示來源 | 檢索失敗同靜默失敗 | 結論能唔能夠附上來源、口徑同更新時間 |
| ④ 定義同實現保持可移植 | 供應商鎖定同返工 | 換一個智能體運行時,同一條問題係唔係同一個答案 |
第二項有個可量化嘅參照:Anthropic 將語義同技能嘅維護直接併入數據工程流程——審查鉤子會標記任何冇同步改動技能檔案嘅數據模型變更,最後約 90% 嘅數據模型合併請求,喺同一個 diff 裏面包含咗技能變更。維護之所以撐得住,係因為佢同改表躺喺同一條評審流水線上。
第三項就承認咗邊界。佢哋嘅線上監控保留對抗性審查(準確率 +6%,但詞元消耗 +32%、延遲 +72%),並明確講「高準確率唔等於消除錯誤」:靜默失敗仍然會發生,所以交畀管理層嘅結論保留人手確認,普通答案就統一帶上來源可信層級、數據新鮮度同責任人。
結語
今個星期真正嘅變化,唔係邊個模型又強咗幾多,而係企業第一次要為「業務含義」呢件事配一個擁有人:邊個負責定義佢,邊個喺數據模型變化時同步佢,邊個喺佢失效時發現佢。
冇維護流程嘅本體,只係一份寫得好靚嘅文件——而文件唔會自己保持正確。喺 OntiCards 嘅四層架構裏面,呢件事落喺語義卡片層:每個業務概念對應一張帶語義、帶查詢範圍、帶敏感級、帶負責人嘅數據卡片,數據模型變更同卡片變更行同一條審核路徑,智能體只可以喺呢啲卡片劃定嘅邊界內取數——呢個亦係點解本體圖記憶會比將歷史 SQL 全部塞畀模型更可靠。想睇睇卡片體系實際上係咩樣,可以由產品頁開始;如果貴團隊正做問數類試點、發現口徑越用越亂,亦歡迎寫信到 hello@onticards.com 傾傾你哋嘅場景。