企业数据智能与AI Agent:语义层的深度应用
本文探讨了语义层在企业数据智能与AI Agent中的应用,分析其在提高数据一致性、简化数据访问和增强数据安全性等方面的优势与挑战。
企业数据智能与 AI Agent 落地:语义层的深度应用
在企业数据治理和 AI 应用中,语义层(Semantic Layer)的作用越来越重要。通过将业务逻辑、数据定义和用户意图统一管理,语义层不仅提高了数据的一致性和准确性,还为企业提供了更灵活的数据访问方式。本文将探讨语义层在企业数据智能与 AI Agent 中的应用,并分析其在实际落地过程中的优势与挑战。
语义层的基本概念与作用
基本概念
语义层是一种抽象层,位于数据源和应用程序之间,用于统一管理和解释数据的业务含义。它通过定义数据的元数据、关系和计算规则,使得不同系统和用户能够以一致的方式理解和使用数据。简单来说,语义层将复杂的底层数据结构转化为易于理解的业务术语。
主要作用
- 提高数据一致性:通过统一定义和管理数据的业务含义,避免了因数据定义不一致导致的误解和错误。
- 简化数据访问:用户无需了解底层数据结构,只需通过语义层提供的接口即可获取所需数据。
- 增强数据安全性:通过对数据访问权限的集中管理,确保敏感数据的安全性。
- 提升开发效率:开发者可以利用语义层的标准化接口进行快速开发,减少重复工作。
具体场景
在与制造企业协作时,常见的情况是同一张报表在财务与生产两套口径里对不上。通过引入语义层,可以将这两套口径统一管理,确保数据的一致性和准确性。此外,在金融行业中,合规性和审计要求极高,语义层可以帮助企业更好地管理和控制数据访问,确保数据使用的合法性和合规性。
语义层在 AI Agent 中的应用
语义层与 AI Agent 的结合
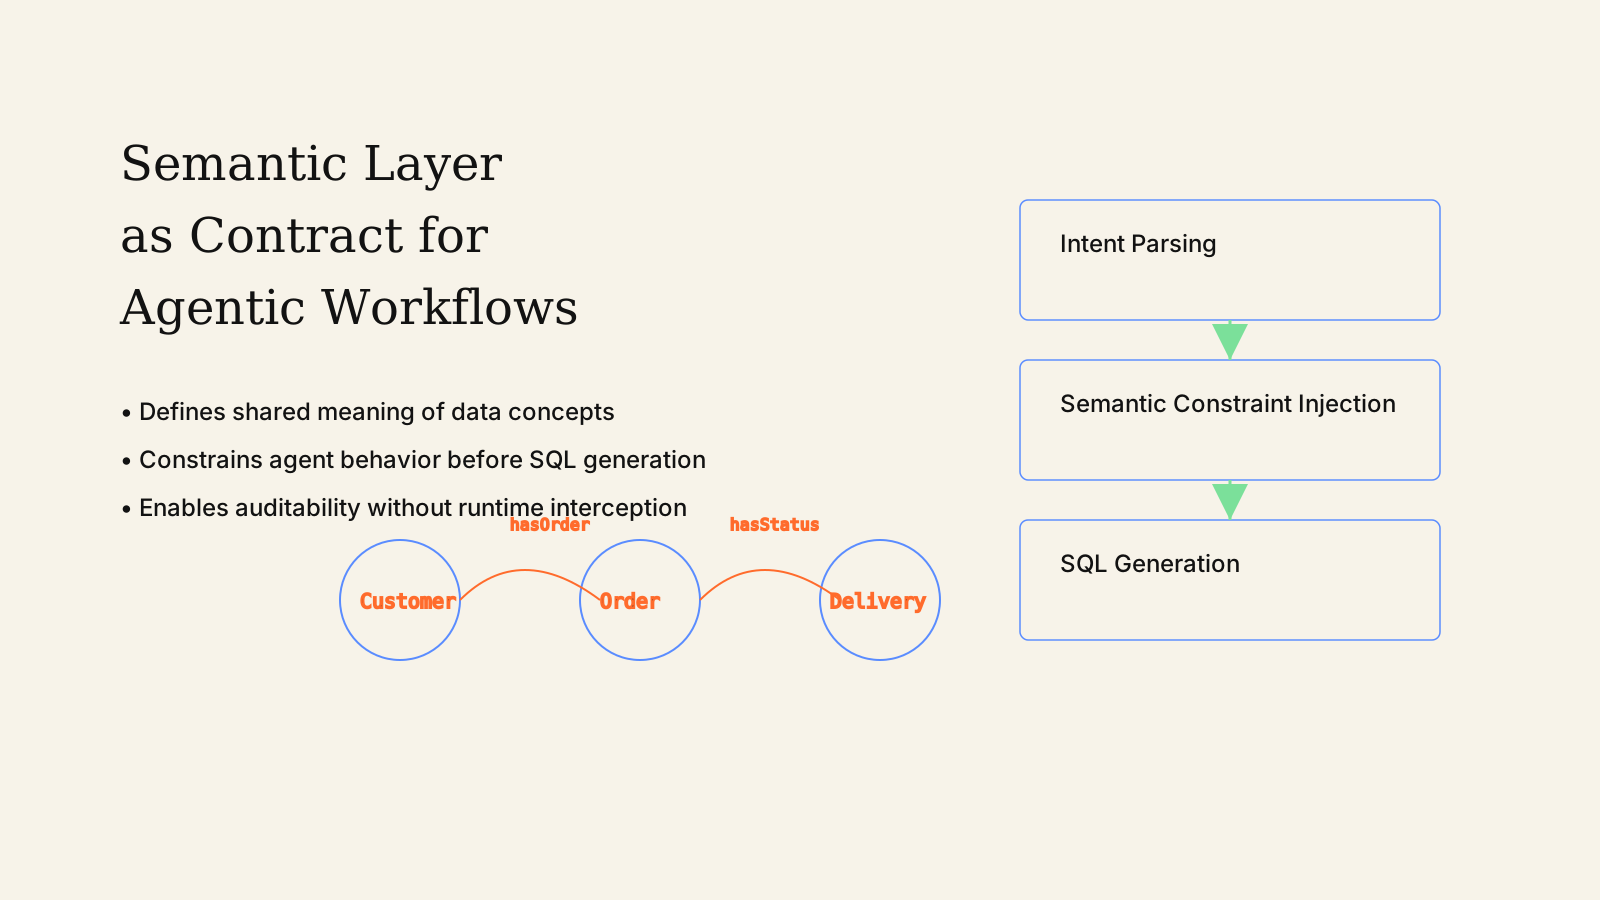
AI Agent 是一种能够在特定环境下自主完成任务的智能代理。通过与语义层结合,AI Agent 可以更好地理解用户的意图和数据需求,从而提供更加精准的服务。具体来说,语义层为 AI Agent 提供了以下支持:
- 意图识别:通过语义层提供的业务词汇表,AI Agent 能够更准确地理解用户的查询意图。
- 数据访问:语义层的标准化接口使得 AI Agent 可以方便地访问和处理数据,而无需关心底层数据结构。
- 权限管理:语义层可以帮助 AI Agent 管理数据访问权限,确保数据使用的合法性。
实际案例
在与部分客户协作的过程中,我们发现通过引入语义层,AI Agent 在处理复杂查询时的表现显著提升。例如,在一个零售企业中,AI Agent 通过语义层理解用户的查询意图,并从多个数据源中提取相关数据,生成详细的销售报告。这种方式不仅提高了查询的准确性,还减少了手动数据处理的工作量。
工程取舍
虽然语义层带来了许多好处,但在实际应用中也存在一些工程上的取舍。首先,语义层的设计和维护需要投入大量的资源,特别是在数据模型和业务逻辑复杂的情况下。其次,语义层的引入可能会增加系统的延迟,特别是在处理大规模数据时。因此,在设计语义层时,需要权衡性能与功能的需求,找到最适合企业的解决方案。
语义层在数据治理中的实践
数据治理的重要性
数据治理是指对数据进行全生命周期管理的过程,包括数据采集、存储、处理、分析和销毁等环节。良好的数据治理可以确保数据的质量、安全性和合规性,为企业提供可靠的数据支持。语义层在数据治理中扮演着重要的角色,主要体现在以下几个方面:
- 数据质量:通过统一管理数据的定义和计算规则,确保数据的一致性和准确性。
- 数据安全:通过对数据访问权限的集中管理,确保敏感数据的安全性。
- 合规性:通过规范数据的使用和管理,确保数据使用的合法性和合规性。
实践路径
在实践中,企业可以通过以下几个步骤来实施语义层:
- 需求分析:明确企业对数据治理的需求,确定语义层的功能和范围。
- 设计与规划:设计语义层的架构,规划数据模型和业务逻辑。
- 实施与部署:根据设计方案实施语义层,并进行测试和优化。
- 运维与监控:对语义层进行持续的运维和监控,确保其稳定运行。
常见反模式
在实施语义层时,常见的反模式包括:
- 过度复杂化:过于复杂的语义层会导致维护困难,增加系统的负担。
- 忽略用户体验:如果语义层的设计忽略了用户体验,可能会导致用户难以理解和使用。
- 缺乏灵活性:如果语义层过于僵化,无法适应业务的变化,会影响其实际效果。
工程取舍
在设计和实施语义层时,需要权衡复杂度与灵活性的关系。一方面,为了确保数据的一致性和准确性,语义层需要具备一定的复杂度;另一方面,为了保证系统的可维护性和用户体验,语义层也需要保持一定的灵活性。因此,在设计时,需要综合考虑业务需求和技术实现,找到最佳的平衡点。
语义层的技术选型与实现
技术选型
在选择语义层的技术方案时,需要考虑以下几个因素:
- 兼容性:语义层应能够兼容多种数据源和数据格式,以便于集成现有的数据系统。
- 性能:语义层的性能直接影响到数据处理的效率,特别是在大规模数据处理场景下。
- 可扩展性:随着业务的发展,语义层需要能够支持更多的数据源和业务逻辑。
- 易用性:语义层应提供友好的用户界面和开发接口,便于用户和开发者使用。
实现路径
实现语义层通常包括以下几个步骤:
- 需求分析:明确企业对语义层的需求,确定功能和范围。
- 技术选型:选择合适的技术方案,包括数据库、中间件和前端框架等。
- 设计与开发:设计语义层的架构和接口,进行开发和测试。
- 部署与优化:将语义层部署到生产环境,并进行性能优化和调试。
工程取舍
在实现语义层时,需要权衡性能与易用性的关系。一方面,为了确保数据处理的高效性,语义层需要具备较高的性能;另一方面,为了提高用户体验,语义层需要提供易用的接口和工具。因此,在实现过程中,需要综合考虑技术选型和实现路径,找到最佳的平衡点。
常见问题
在实现语义层时,常见的问题包括:
- 性能瓶颈:大规模数据处理场景下,语义层可能会成为性能瓶颈。
- 兼容性问题:不同的数据源和数据格式可能带来兼容性问题。
- 维护成本:复杂的语义层需要投入大量的资源进行维护。
针对这些问题,可以通过优化架构、选择合适的技术方案和持续改进等方式来解决。
结论
语义层在企业数据智能与 AI Agent 中的应用,不仅可以提高数据的一致性和准确性,还能简化数据访问和增强数据安全性。通过合理的规划和实施,企业可以充分利用语义层的优势,提升数据治理和 AI 应用的效果。在未来,随着技术的发展,语义层将在更多领域发挥重要作用,成为企业数据管理的重要组成部分。
参考来源
- 本文基于公开行业资料与作者实践经验整理。
- (无外部引用)