语义层是 AI Agent 的契约载体
语义层不是数据中台的装饰性模块,而是 AI Agent 与企业数据系统之间可验证、可追溯、可审计的契约载体。本文剖析其在 NL2SQL、权限对齐与本体建模中的核心作用。
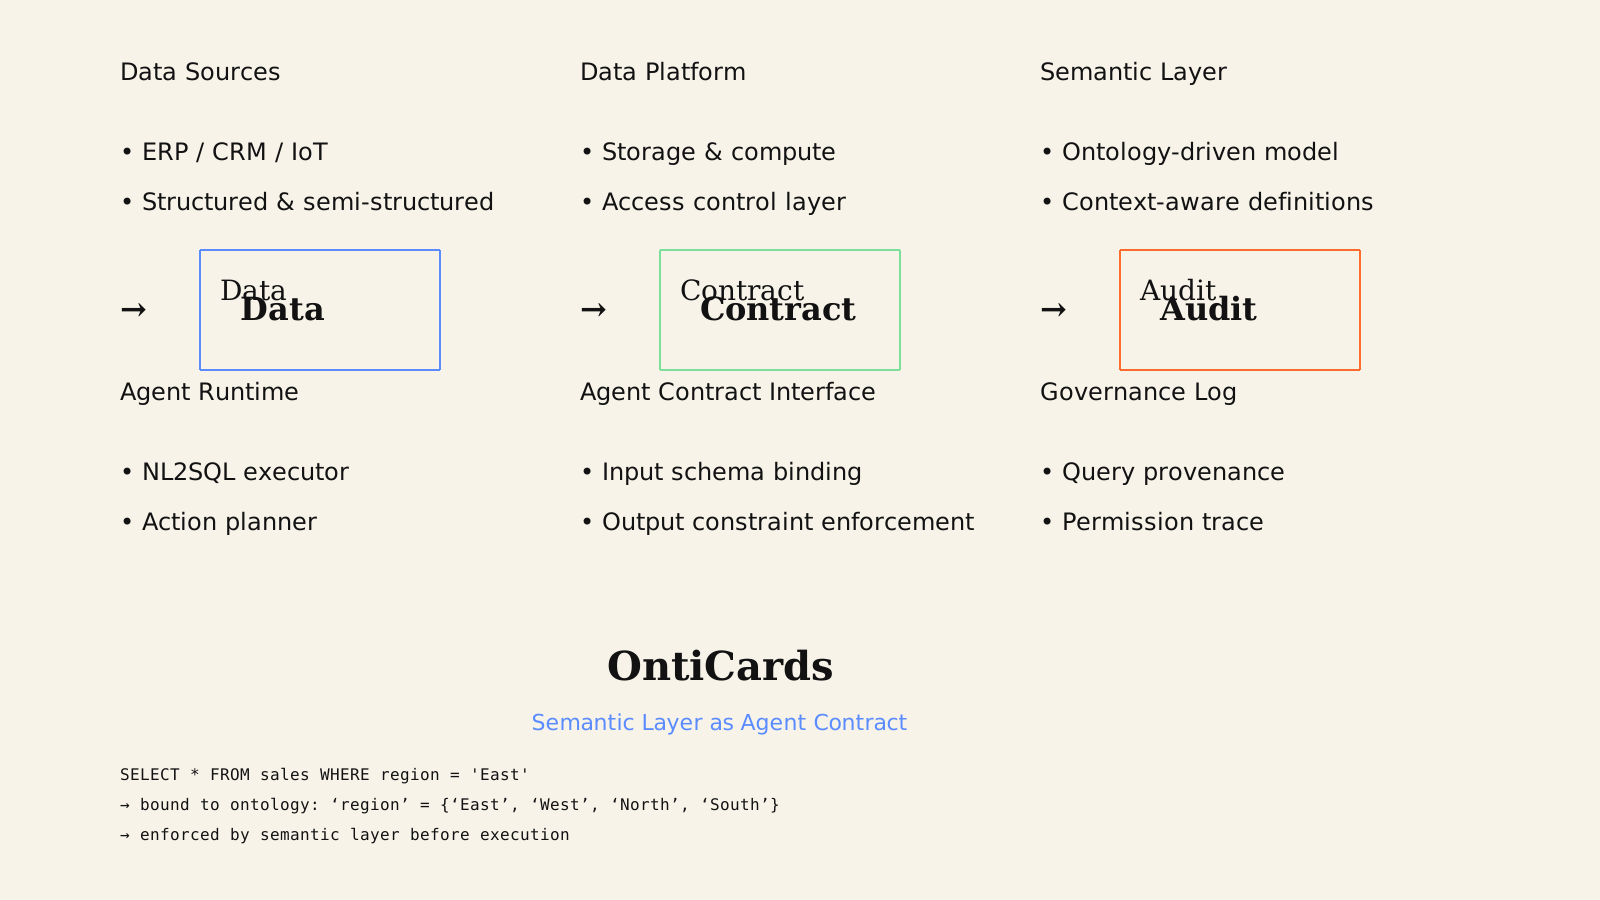
企业部署 AI Agent 后最常遇到的并非能力不足,而是「行为不可控」:同一自然语言请求,在不同时间、由不同 Agent 发起,可能命中不同表、触发不同权限逻辑、返回口径不一致的结果。问题根源不在模型本身,而在于缺乏一套被所有参与方共同承认并强制执行的「数据契约」——语义层正是这一契约的技术具象。
语义层的本质是契约,不是映射
传统语义层常被简化为「字段别名 + 表关联」的配置界面。这种理解忽略了其治理本质:它定义了「什么可以被说、如何被说、谁可以说、结果应为何种形态」。当一个 Agent 提交 NL2SQL 请求时,语义层不是被动翻译 SQL,而是主动校验:
- 输入是否在预定义上下文内(例如,“上季度”必须绑定到财务日历而非自然日历);
- 所涉概念是否存在歧义消解规则(例如,“客户”在销售域指签约主体,在售后域指服务对象);
- 输出是否满足业务一致性约束(例如,所有营收类指标必须经「收入确认准则」校验)。
这已超出元数据管理范畴,进入契约工程(Contract Engineering)领域。
NL2SQL 的瓶颈不在生成,而在约束注入
当前多数 NL2SQL 方案将优化重心放在模型微调或提示工程上,但真实场景中,准确率的天花板往往由语义层决定。例如,在与制造企业协作时,常见的情况是同一张报表在财务与生产两套口径里对不上。此时提升效果的关键,不是更换更大参数量的模型,而是将「成本中心归属规则」「工单状态流转逻辑」等业务知识沉淀为语义层中的约束条件,并在查询解析阶段即介入。
换言之:模型负责「把话说对」,语义层负责「确保话只能这么被说」。
权限与口径必须耦合在语义定义中
权限控制若仅靠 RBAC 或行级策略,会面临「策略漂移」风险:当一张表新增字段、一个视图重构逻辑、一种新分析场景出现,权限规则未必同步更新。而语义层天然具备上下文感知能力。它可将「可访问性」定义为概念属性的一部分:
concept: SalesRevenue {
  permission: "finance_team AND (region = 'APAC')"
  validity: "valid_from <= CURRENT_DATE <= valid_to"
}
这种声明式定义使权限成为数据含义不可分割的部分,而非外挂策略。当 Agent 请求「亚太区上季度营收」时,语义层自动完成权限校验与时间范围归一化,无需运行时再查策略引擎。
本体驱动建模:让契约可推理、可演化
轻量级语义层依赖手工配置,难以应对复杂业务演化。真正支撑 Agent 长期可信运行的,是基于本体(Ontology)的建模方式。它不只定义「是什么」,更表达「为什么这样定义」以及「与其他概念的逻辑关系」。
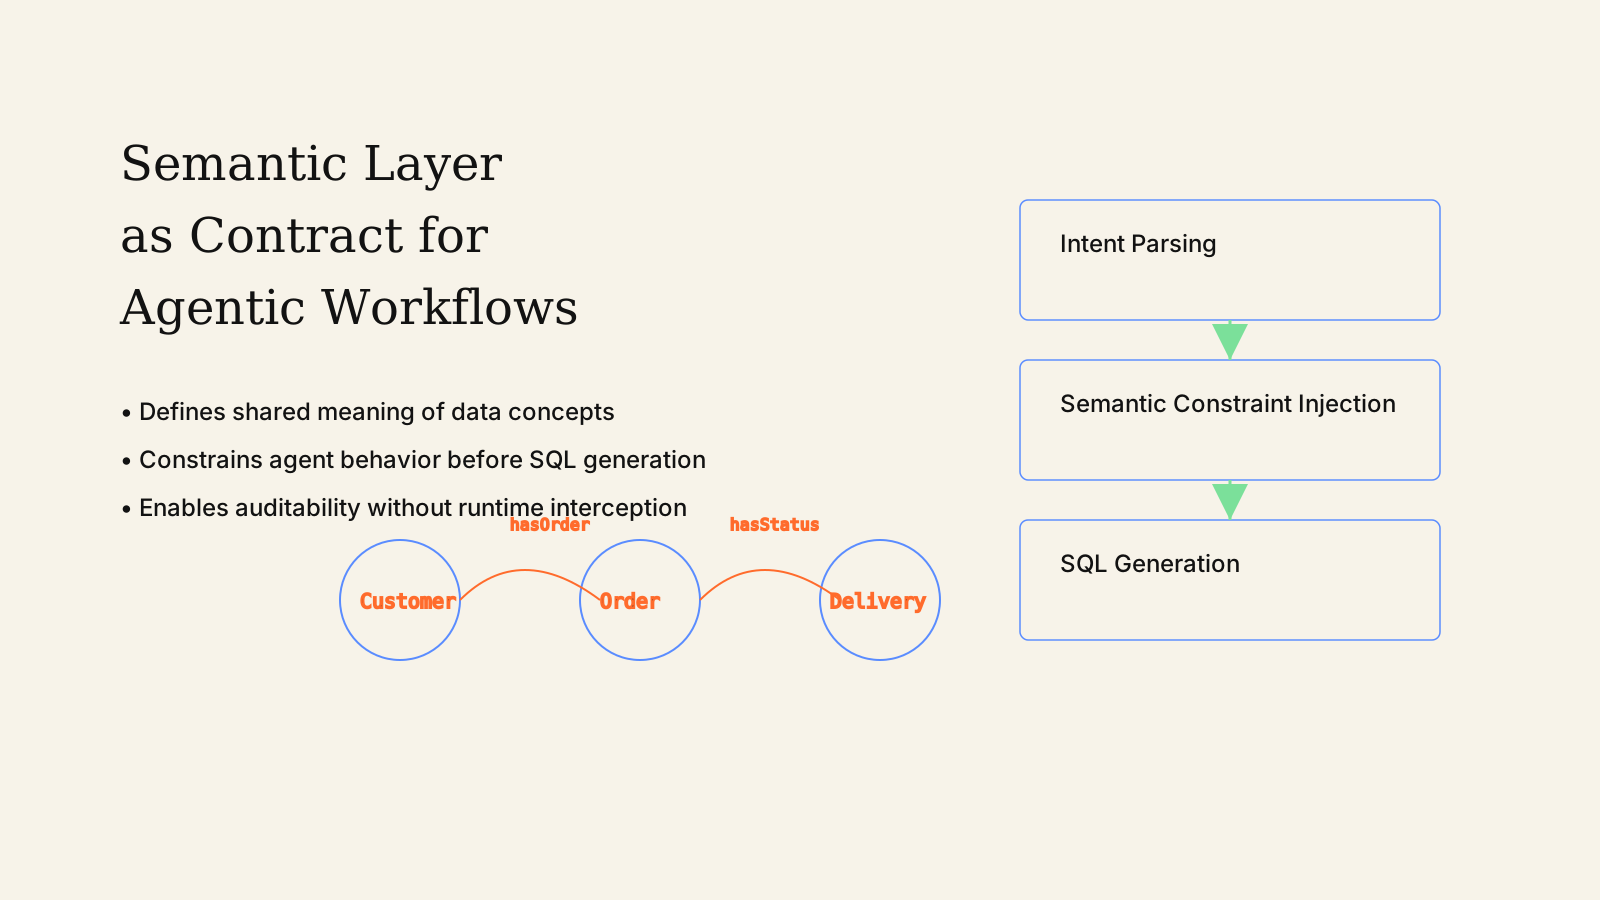
例如,定义 Customer 概念时,不仅标注其来源字段,还声明:
isSubClassOf Person
hasRelationship contractWith Company
hasConstraint lifecycleStatus IN {‘Prospect’, ‘Active’, ‘Churned’}
这些逻辑断言使语义层具备基础推理能力:当 Agent 查询「流失客户关联的未结清合同数」时,系统可自动推导出需联合 Customer、Contract 及其状态约束,而非依赖人工编写 JOIN 逻辑。
组织落地的关键取舍:先契约,后智能
不少团队试图「一步到位」:直接训练 Agent 理解原始数据库 Schema。结果是模型在测试集表现尚可,上线后因业务变更频繁导致行为失稳。更稳健的路径是分两步走:
- 先固化契约:用语义层收拢数据口径、权限边界与业务规则,形成稳定输入面;
- 再释放智能:在此之上构建 NL2SQL、Agent 工作流与审计追踪能力。
这看似降低初期灵活性,实则大幅提升长期可维护性。因为契约一旦确立,后续模型迭代、Agent 升级甚至底层数据平台迁移,都可在语义层隔离变化。
语义层的价值,从来不在它「做了什么」,而在于它「阻止了什么」——阻止模糊请求越过业务红线,阻止权限逻辑与数据定义脱钩,阻止 AI 行为脱离组织治理框架。它不是数据管道上的一个环节,而是人、Agent 与数据系统之间默认签署的那份沉默协议。
参考来源
- The Semantic Layer Is Not Optional — Sisense Blog, 2023